


 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
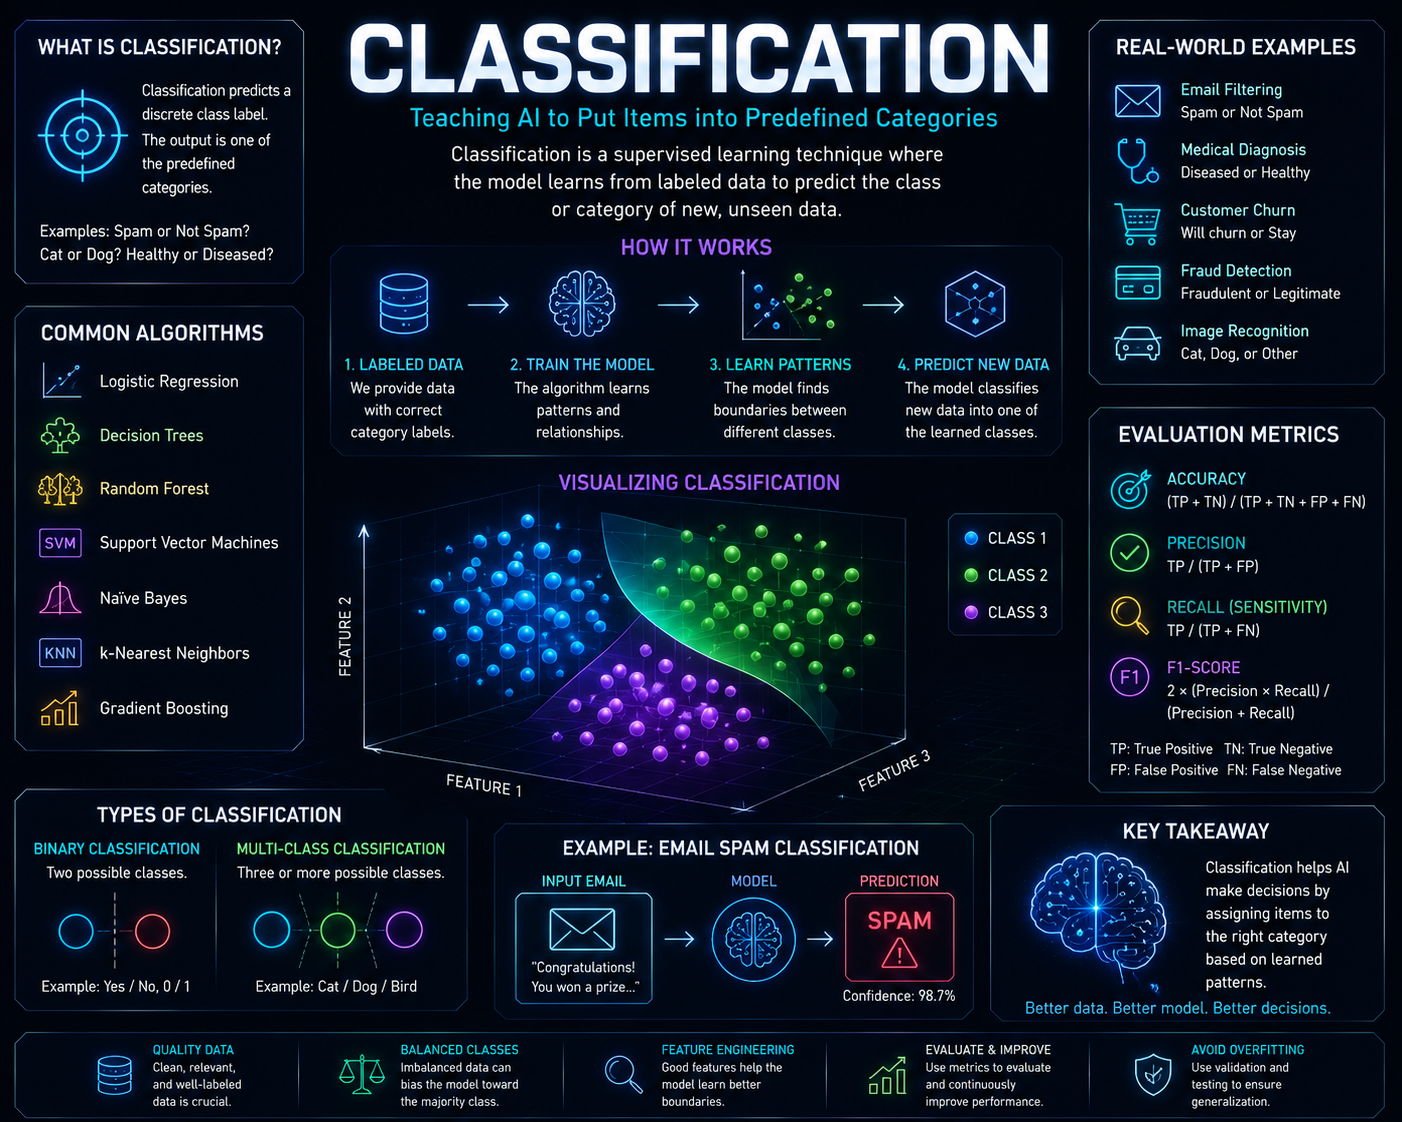
Klasyfikacja
Klasyfikacja to zadanie sztucznej inteligencji, w ramach którego system przypisuje coś do określonej kategorii. Przykłady obejmują sortowanie wiadomości e-mail na spam i nie-spam, identyfikowanie, czy recenzja jest pozytywna czy negatywna, lub wykrywanie, czy zdjęcie rentgenowskie wygląda normalnie czy nieprawidłowo. Klasyfikacja jest jednym z najczęstszych zastosowań uczenia maszynowego.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
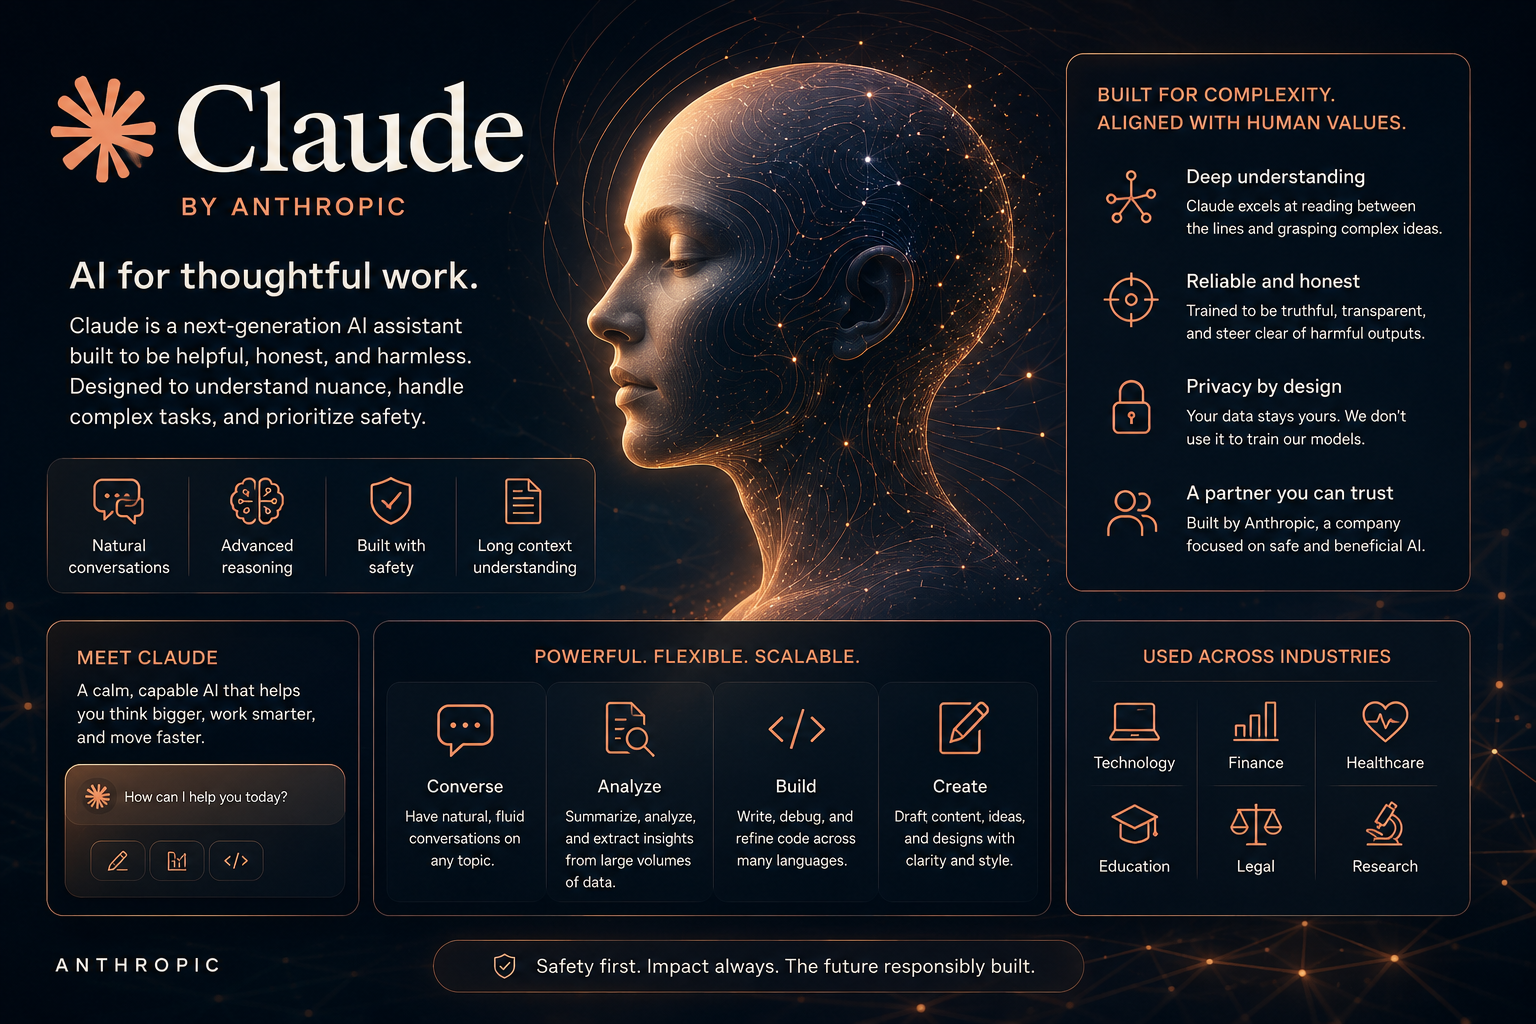
Claude
Claude to zaawansowana rodzina dużych modeli językowych opracowana przez firmę Anthropic. Zaprojektowana z myślą o bezpieczeństwie, dokładności i ochronie danych, oferuje specjalistyczne narzędzia, takie jak Claude Code (narzędzie do kodowania agentowego), Claude Design oraz Claude Science przeznaczone do badań naukowych. Nazwa Claude pochodzi od słynnego Claude'a Shannona – matematyka, informatyka i ojca teorii informacji.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
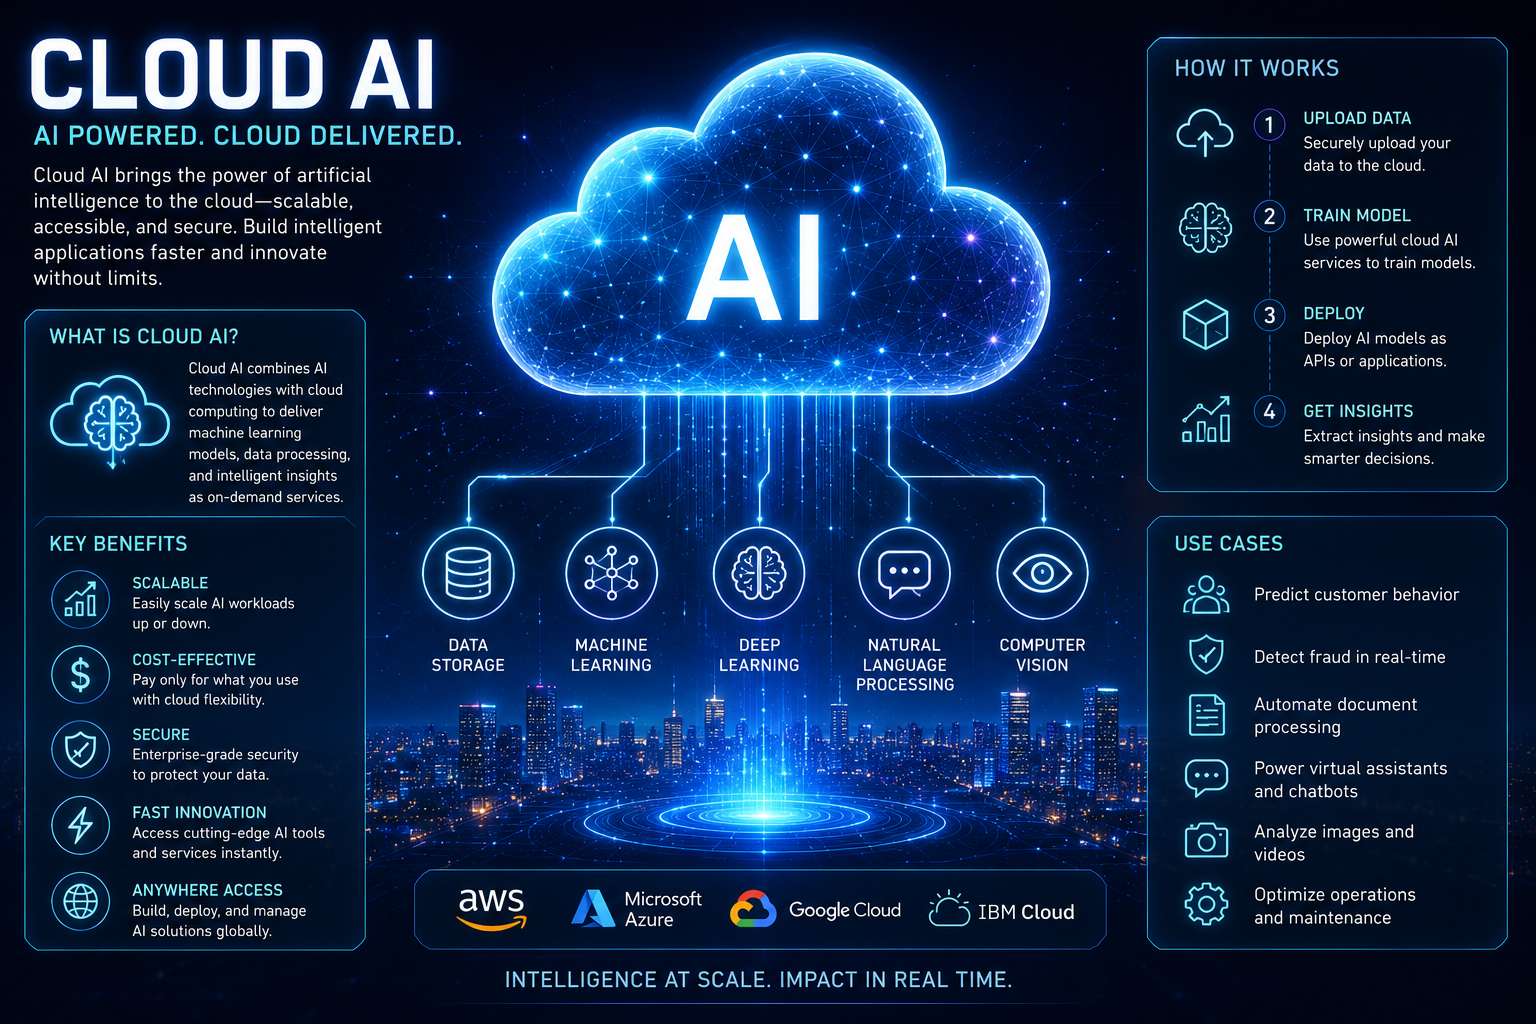
Sztuczna inteligencja w chmurze
Cloud AI odnosi się do usług sztucznej inteligencji dostarczanych przez Internet przez dużych dostawców usług obliczeniowych. Zamiast kupować drogi sprzęt, firmy mogą uzyskać dostęp do modeli AI, pamięci masowej i mocy obliczeniowej za pośrednictwem platform chmurowych. Sprawia to, że sztuczna inteligencja staje się bardziej dostępna, ale rodzi również pytania dotyczące prywatności danych, bezpieczeństwa, kosztów oraz zależności od dużych firm technologicznych.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
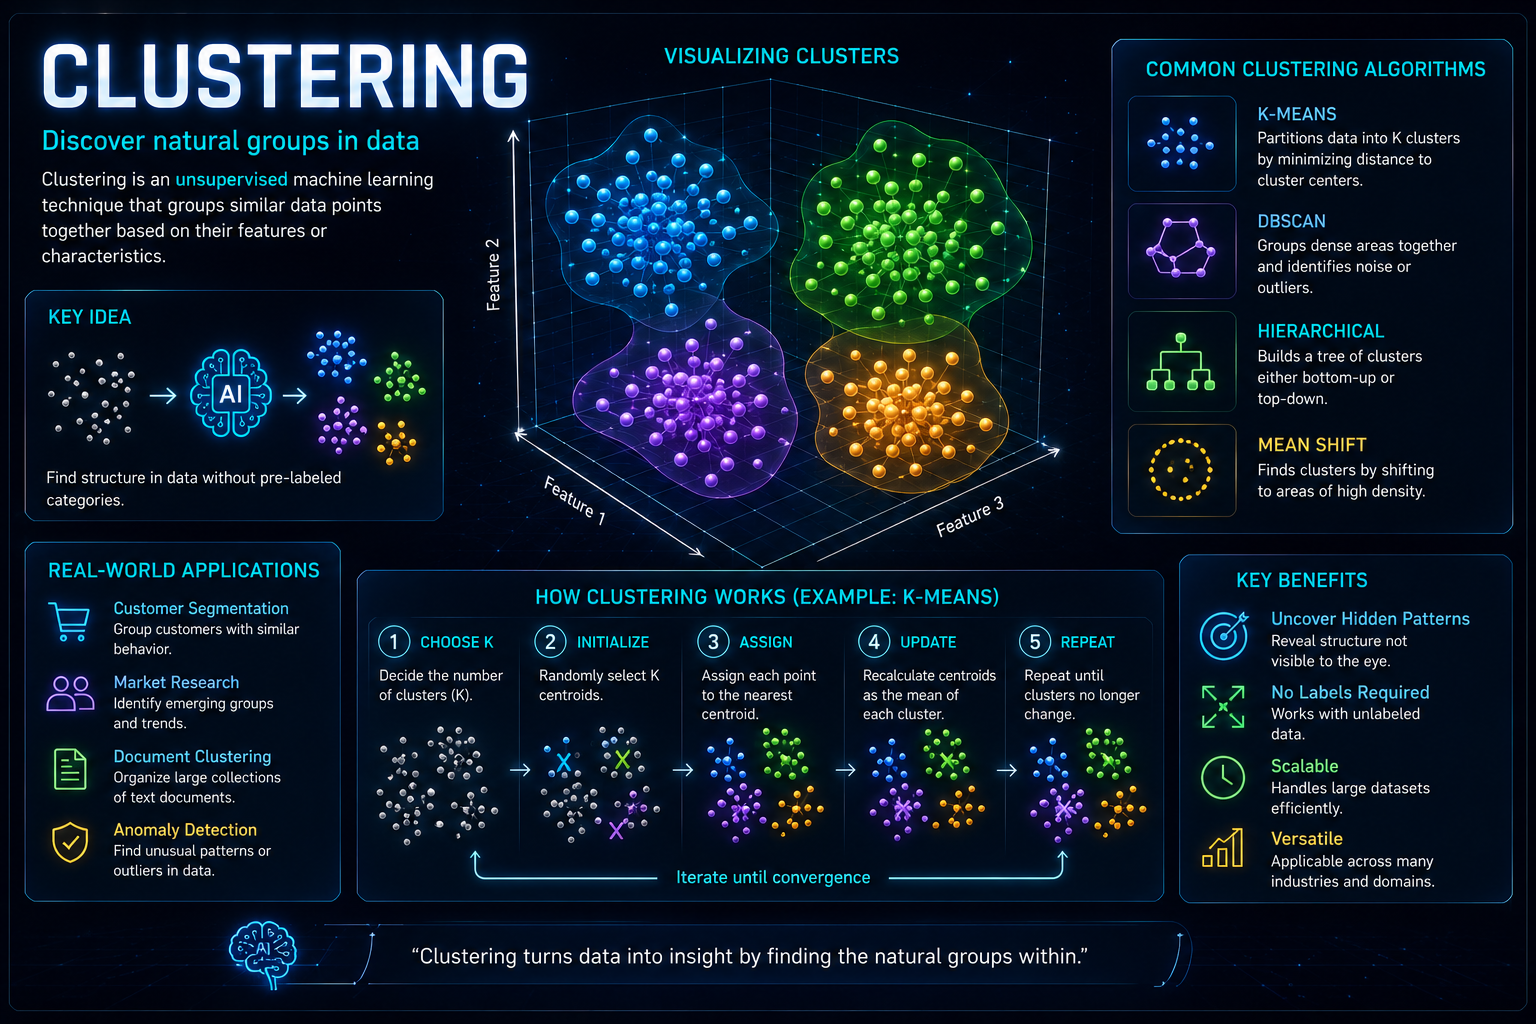
Klasteryzacja
Klasteryzacja to metoda uczenia maszynowego, która grupuje podobne elementy bez konieczności wcześniejszego określenia prawidłowych kategorii. Na przykład sprzedawca detaliczny może wykorzystać klasteryzację do zidentyfikowania grup klientów o podobnych nawykach zakupowych. Klasteryzacja jest przydatna do odkrywania wzorców, ale znalezione przez nią grupy nadal wymagają interpretacji przez człowieka.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
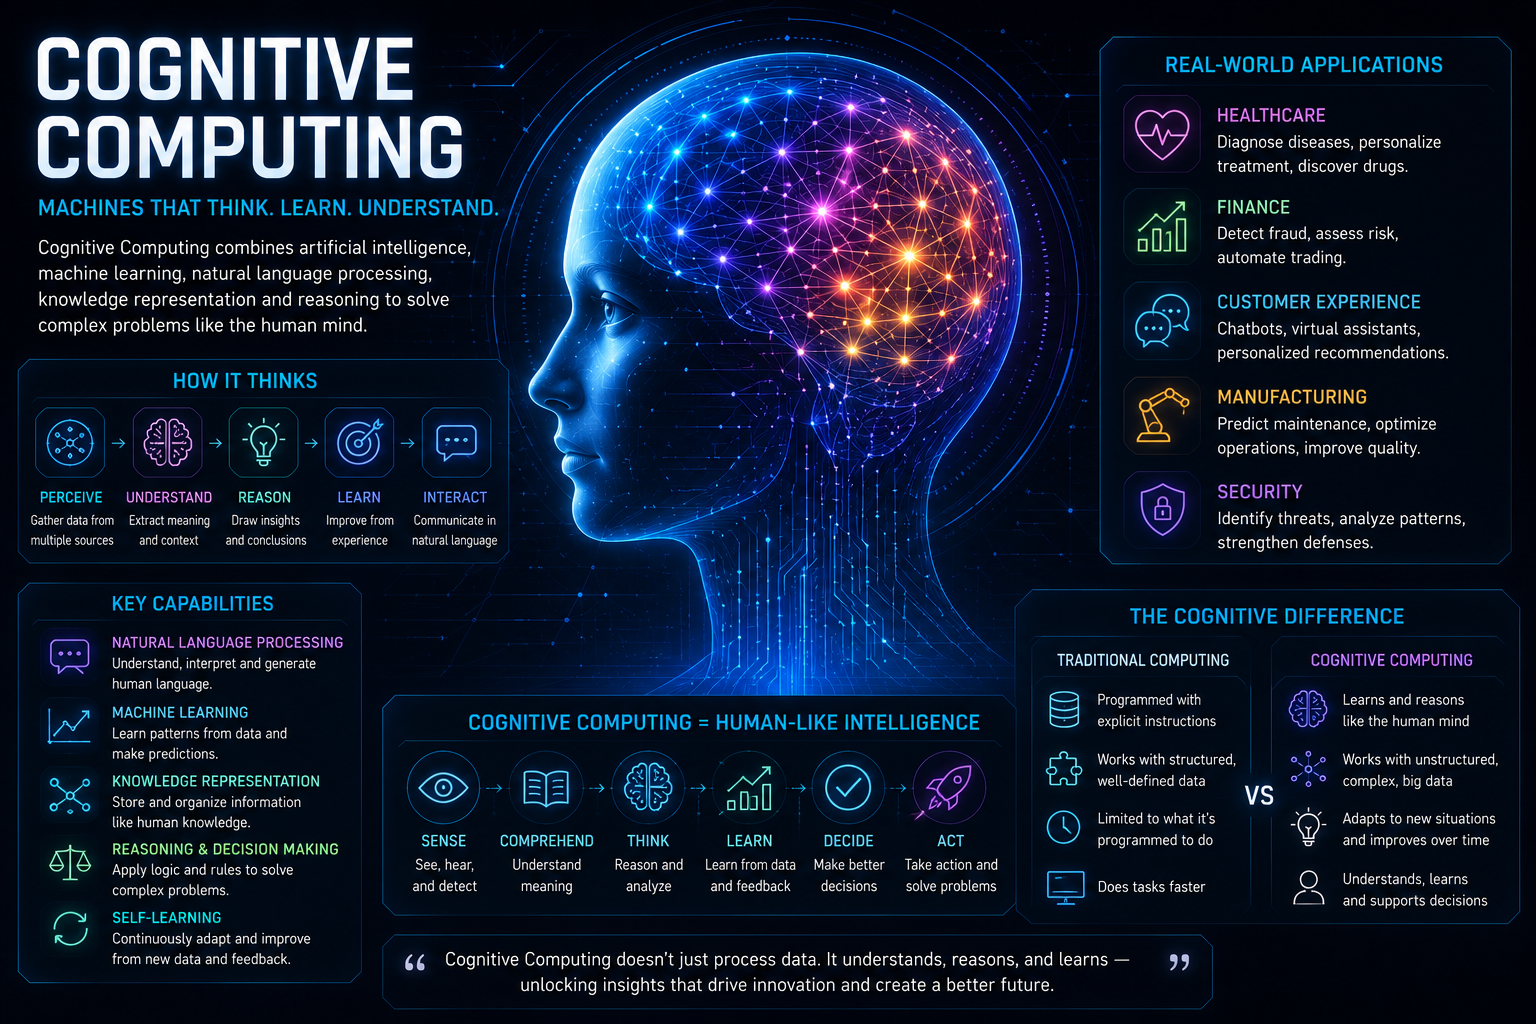
Przetwarzanie kognitywne
Przetwarzanie kognitywne to starsze i szersze pojęcie odnoszące się do systemów zaprojektowanych w celu naśladowania aspektów ludzkiego myślenia, takich jak uczenie się, wnioskowanie i rozumienie języka. Termin ten jest często używany w kontekście biznesowym. Obecnie częściej mówi się o sztucznej inteligencji, uczeniu maszynowym i generatywnej sztucznej inteligencji, ale podstawowa idea pozostaje ta sama: wykorzystanie komputerów do wspierania złożonych zadań wykonywanych w stylu ludzkim.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
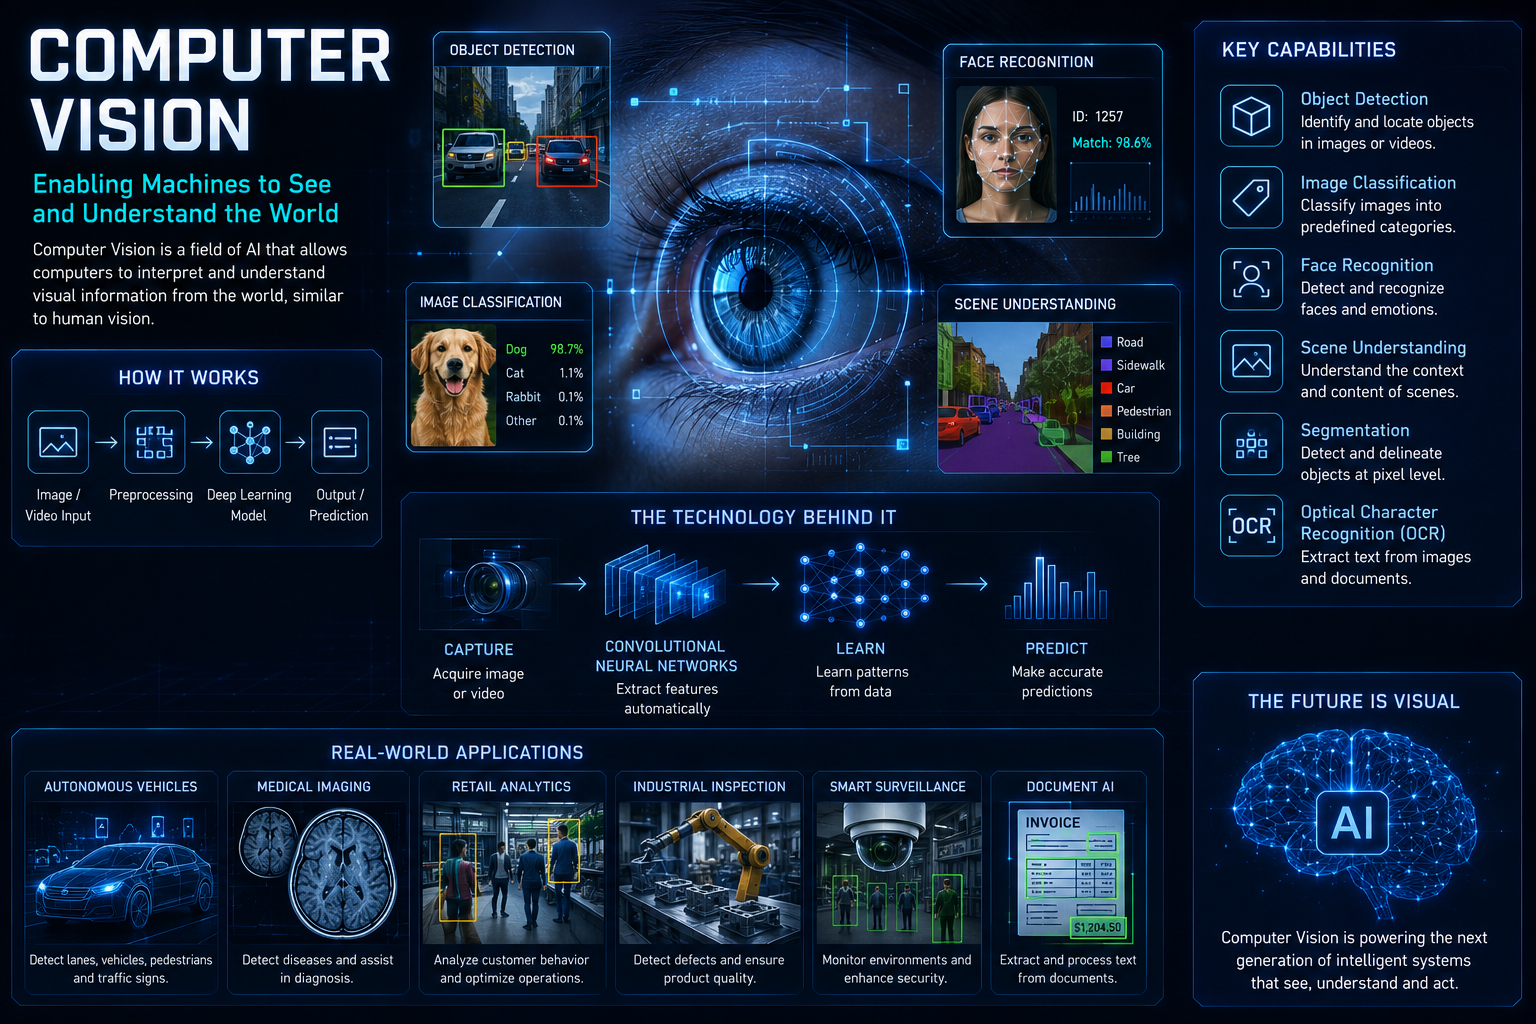
Wizja komputerowa
Wizja komputerowa to dziedzina sztucznej inteligencji, która pomaga komputerom interpretować obrazy i filmy. Znajduje zastosowanie w obrazowaniu medycznym, rozpoznawaniu twarzy, samochodach autonomicznych, kontroli jakości, rolnictwie, bezpieczeństwie oraz analizie sportowej. Systemy wizji komputerowej mogą być bardzo wydajne, ale mogą zawieść, gdy oświetlenie, kąty, tło lub rzeczywiste warunki różnią się od danych szkoleniowych.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
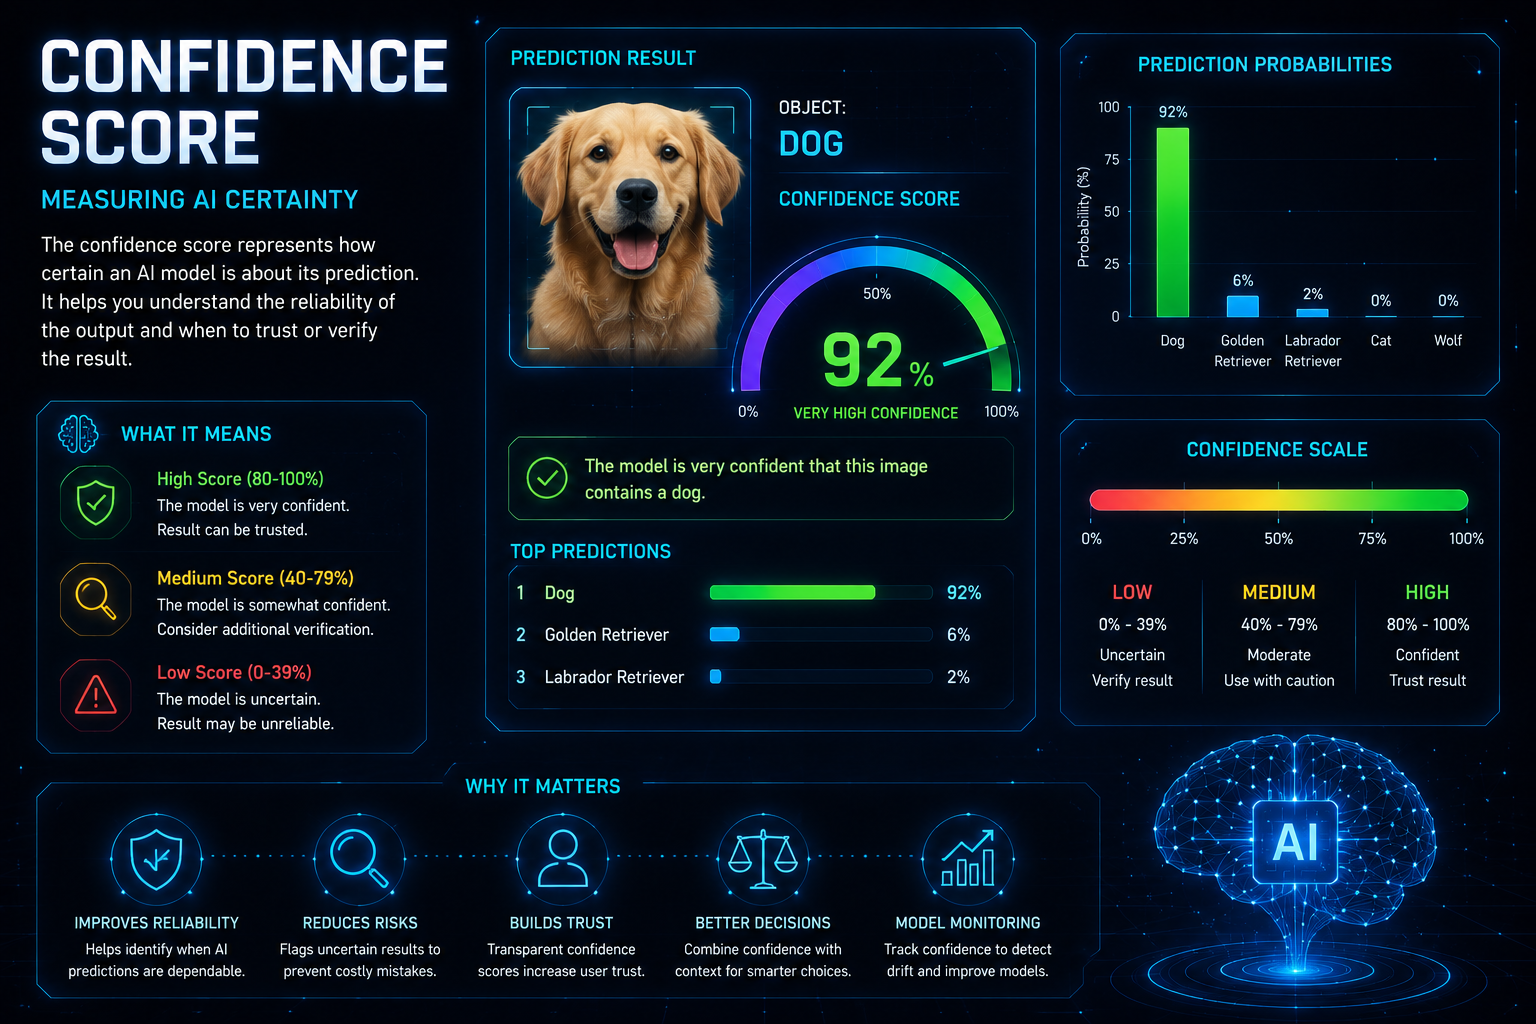
Wskaźnik pewności
Wskaźnik pewności to liczba pokazująca, na ile system sztucznej inteligencji jest pewien swojego wyniku. Na przykład klasyfikator obrazów może stwierdzić, że ma 92% pewności, iż na zdjęciu widnieje pies. Wskaźniki pewności mogą być przydatne, ale nie stanowią gwarancji. Niektóre systemy sztucznej inteligencji są zbyt pewne siebie, nawet gdy się mylą, dlatego tak ważne są kalibracja i testowanie.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
Okno kontekstowe
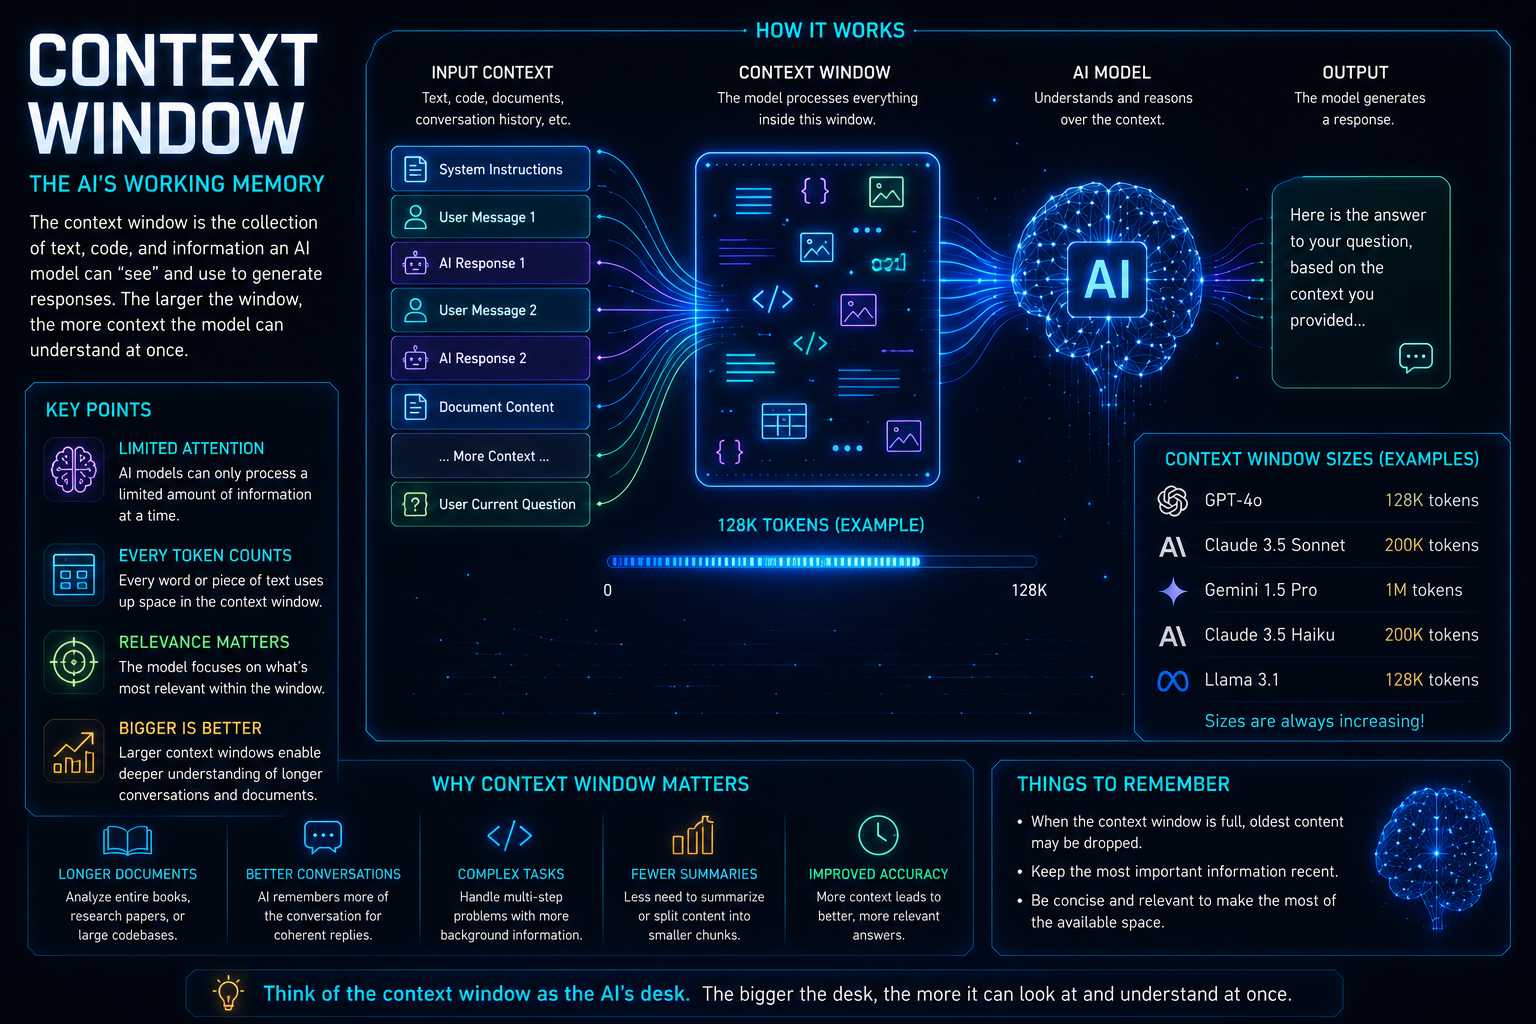
Okno kontekstowe to ilość informacji, które model językowy może uwzględnić jednocześnie. Może ono obejmować pytanie użytkownika, wcześniejszą rozmowę, przesłany tekst lub pobrane dokumenty. Większe okno kontekstowe pozwala modelowi pracować z dłuższymi dokumentami i większą ilością informacji dodatkowych. Jednak nawet przy dużym oknie kontekstowym model może nadal pomijać szczegóły lub nadawać niektórym informacjom wyższy priorytet niż innym. Wielu przedstawicieli branży uważa, że zmierzamy w kierunku nieskończonych okien kontekstowych – czyli takich, których użytkownik nie musi już brać pod uwagę.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
Konwolucyjna sieć neuronowa
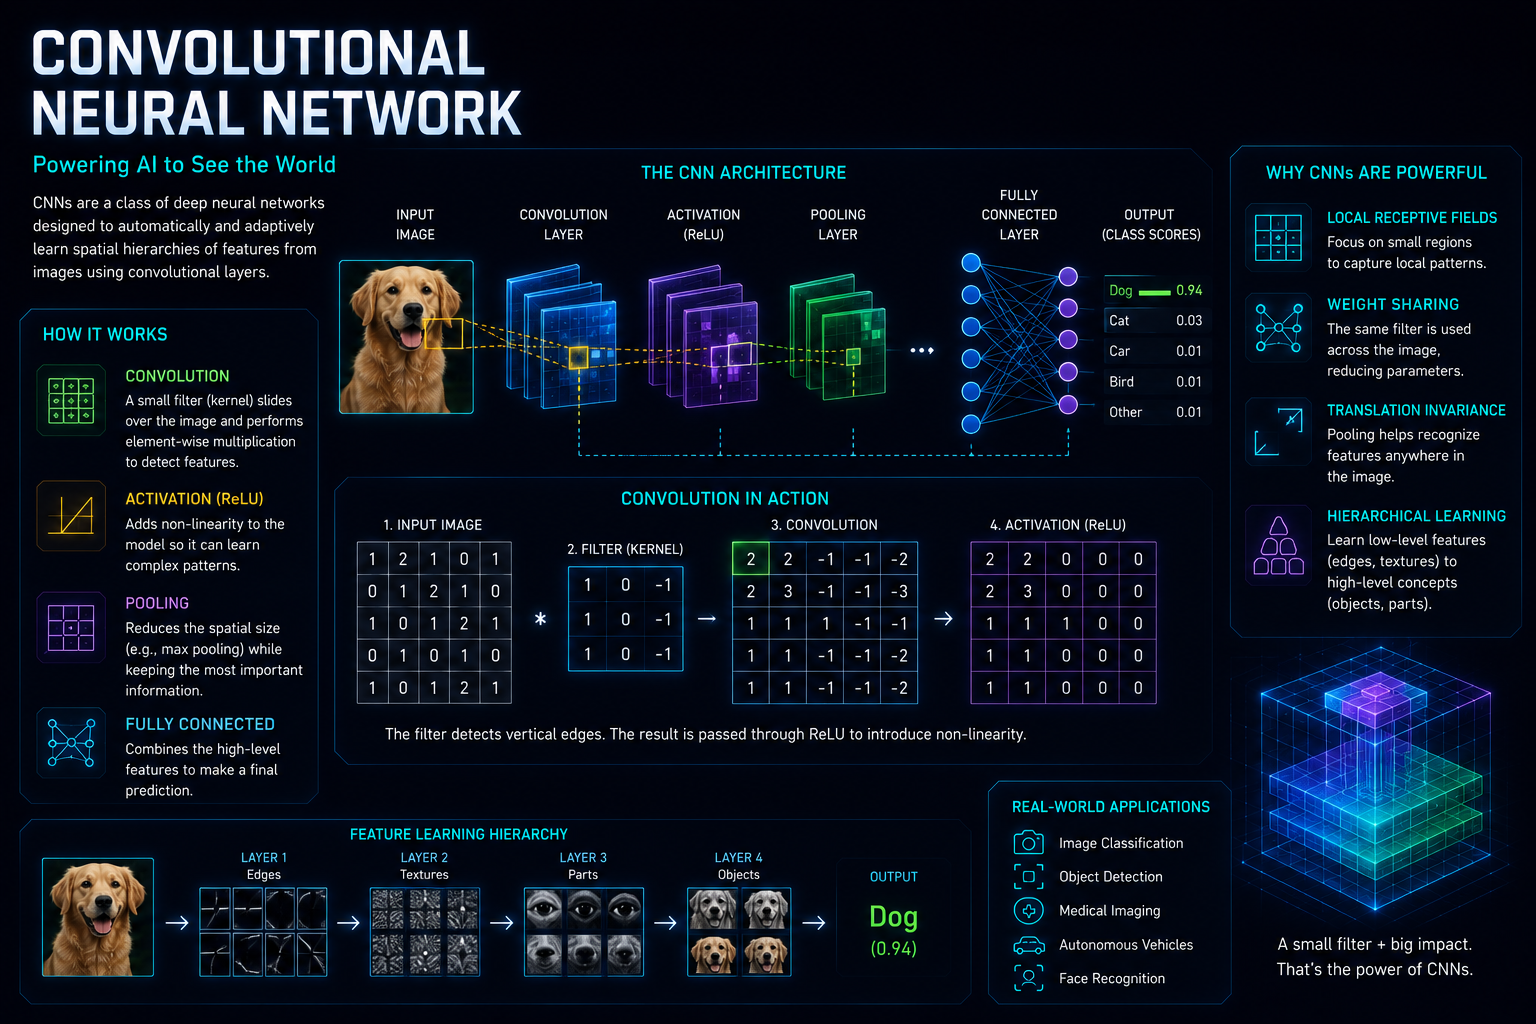
Konwolucyjna sieć neuronowa (CNN) to rodzaj sieci neuronowej szczególnie przydatnej w przypadku obrazów. Sieci CNN wykrywają wzorce, takie jak krawędzie, kształty, tekstury i obiekty. Odegrały one znaczącą rolę w rozwoju wizji komputerowej. Chociaż obecnie stosuje się również nowsze architektury, sieci CNN nadal odgrywają ważną rolę w analizie obrazów, obrazowaniu medycznym i rozpoznawaniu wizualnym.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
Korpus
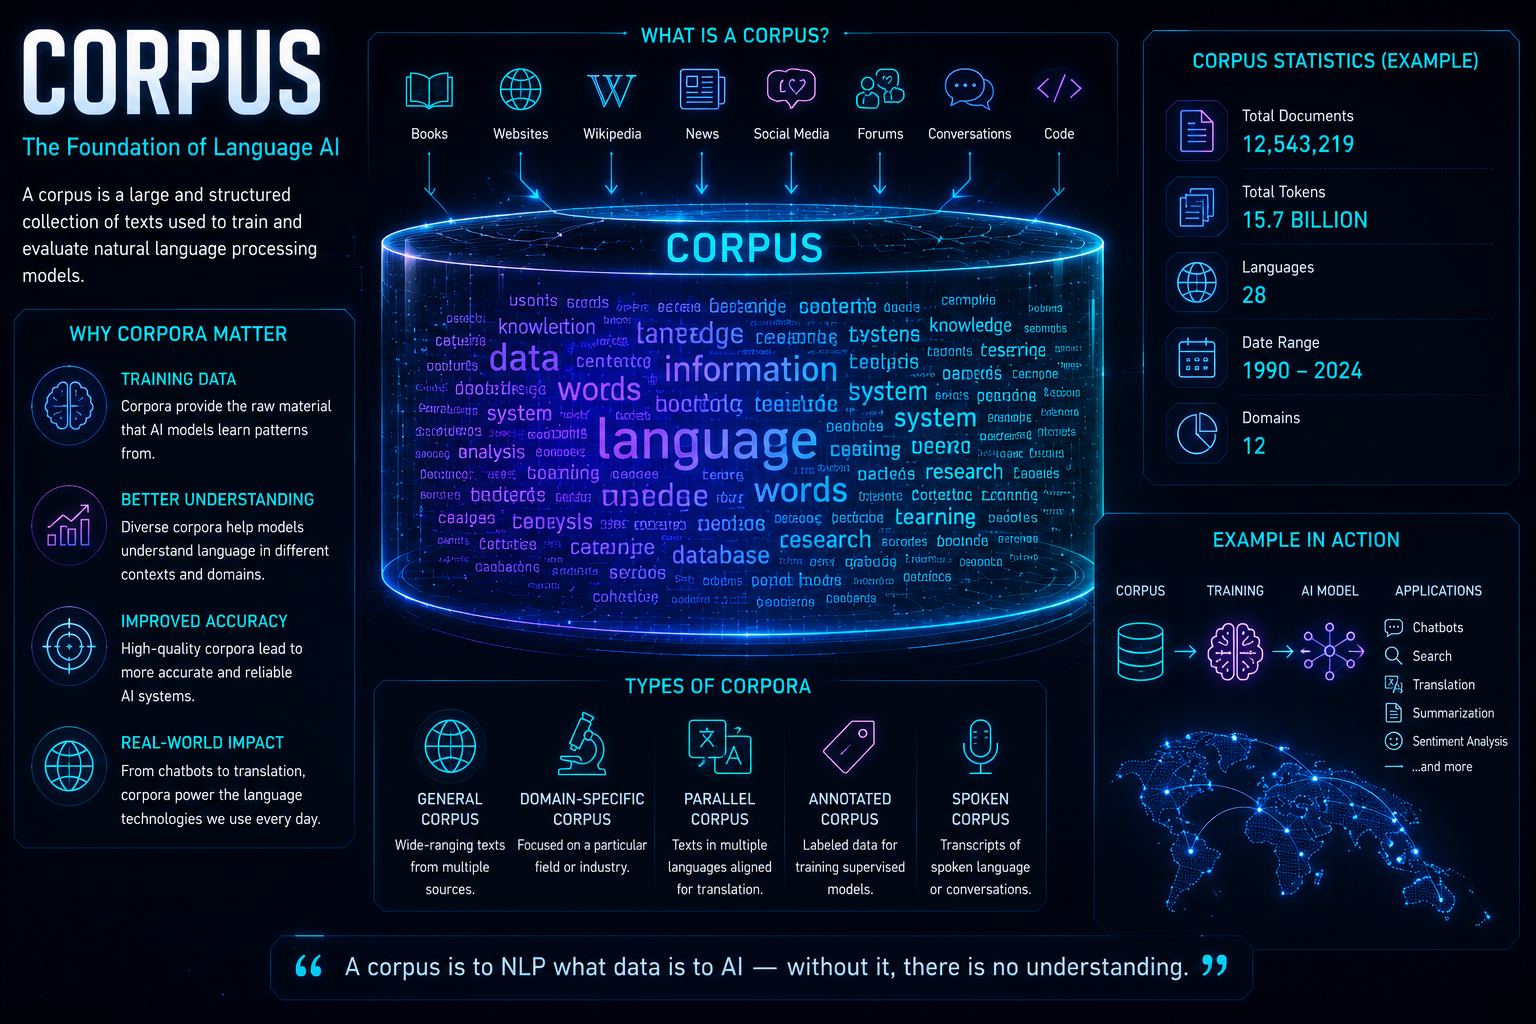
Korpus to zbiór tekstów lub danych wykorzystywanych do analizy lub uczenia. Na przykład model językowy może być trenowany na korpusie zawierającym książki, artykuły, strony internetowe, kod i inne materiały pisemne. Jakość i skład korpusu mają duży wpływ na zachowanie modelu. Jeśli korpus zawiera błędy, stronniczość lub nieaktualne informacje, model może się ich również nauczyć.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
Funkcja kosztu
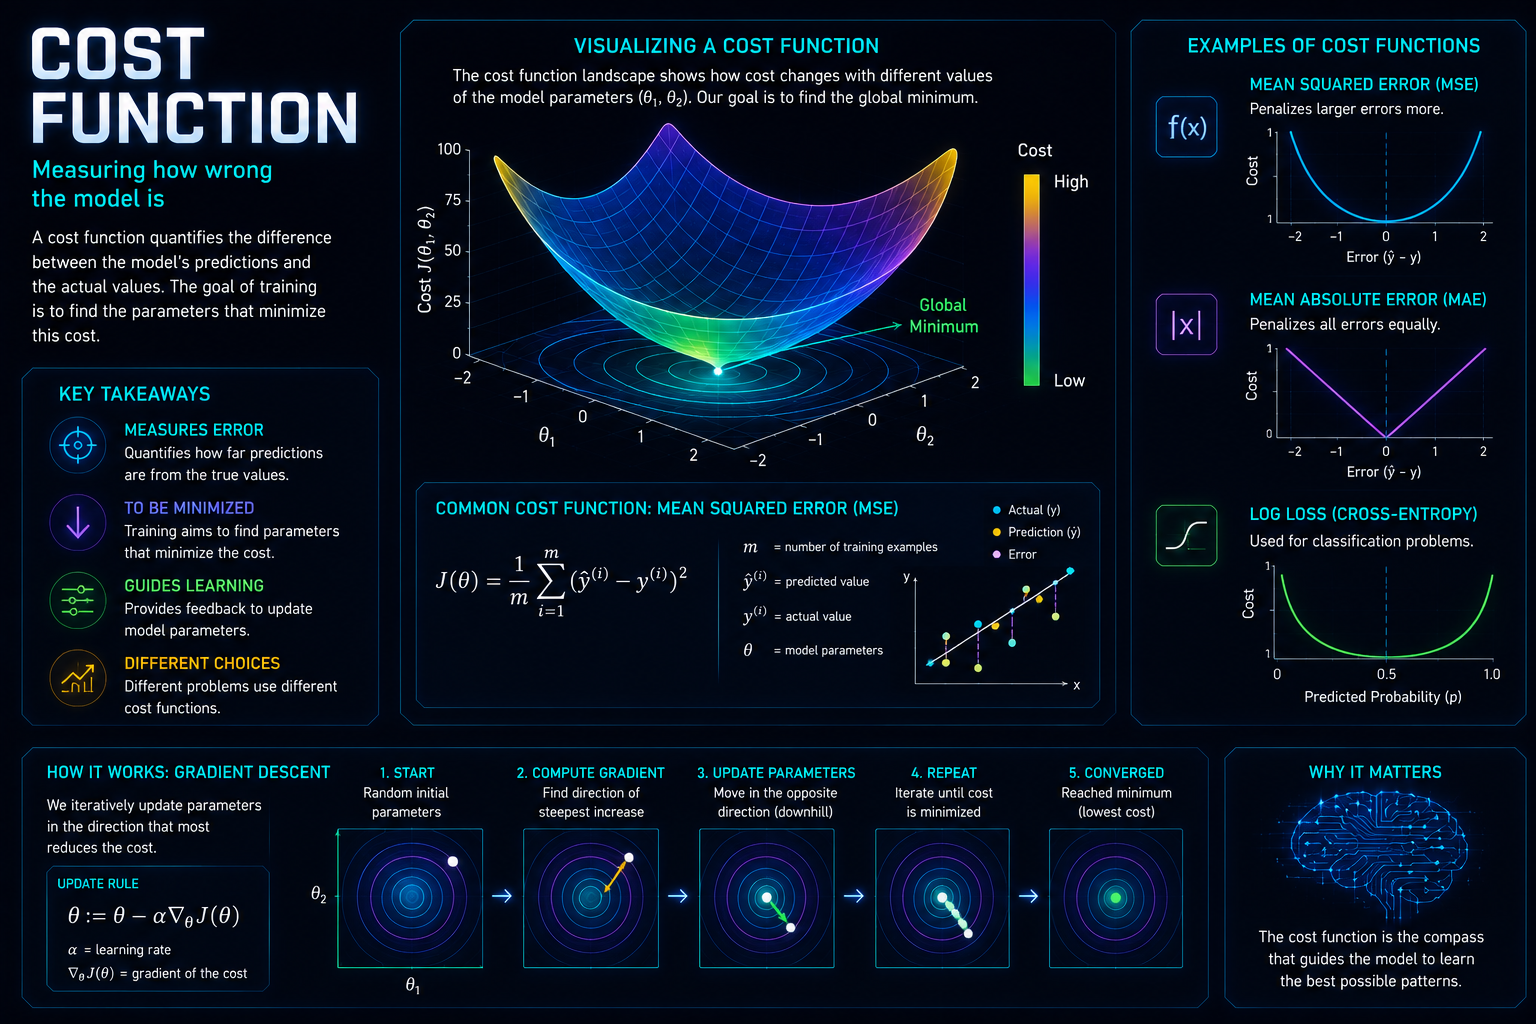
Funkcja kosztu, zwana również funkcją straty, mierzy stopień błędu modelu podczas uczenia. Model stara się z czasem zmniejszyć ten błąd. Na przykład, jeśli sztuczna inteligencja prognozuje ceny domów, funkcja kosztu mierzy różnicę między cenami prognozowanymi a rzeczywistymi. Uczenie się jest zasadniczo procesem dostosowywania modelu w celu zminimalizowania tej straty.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
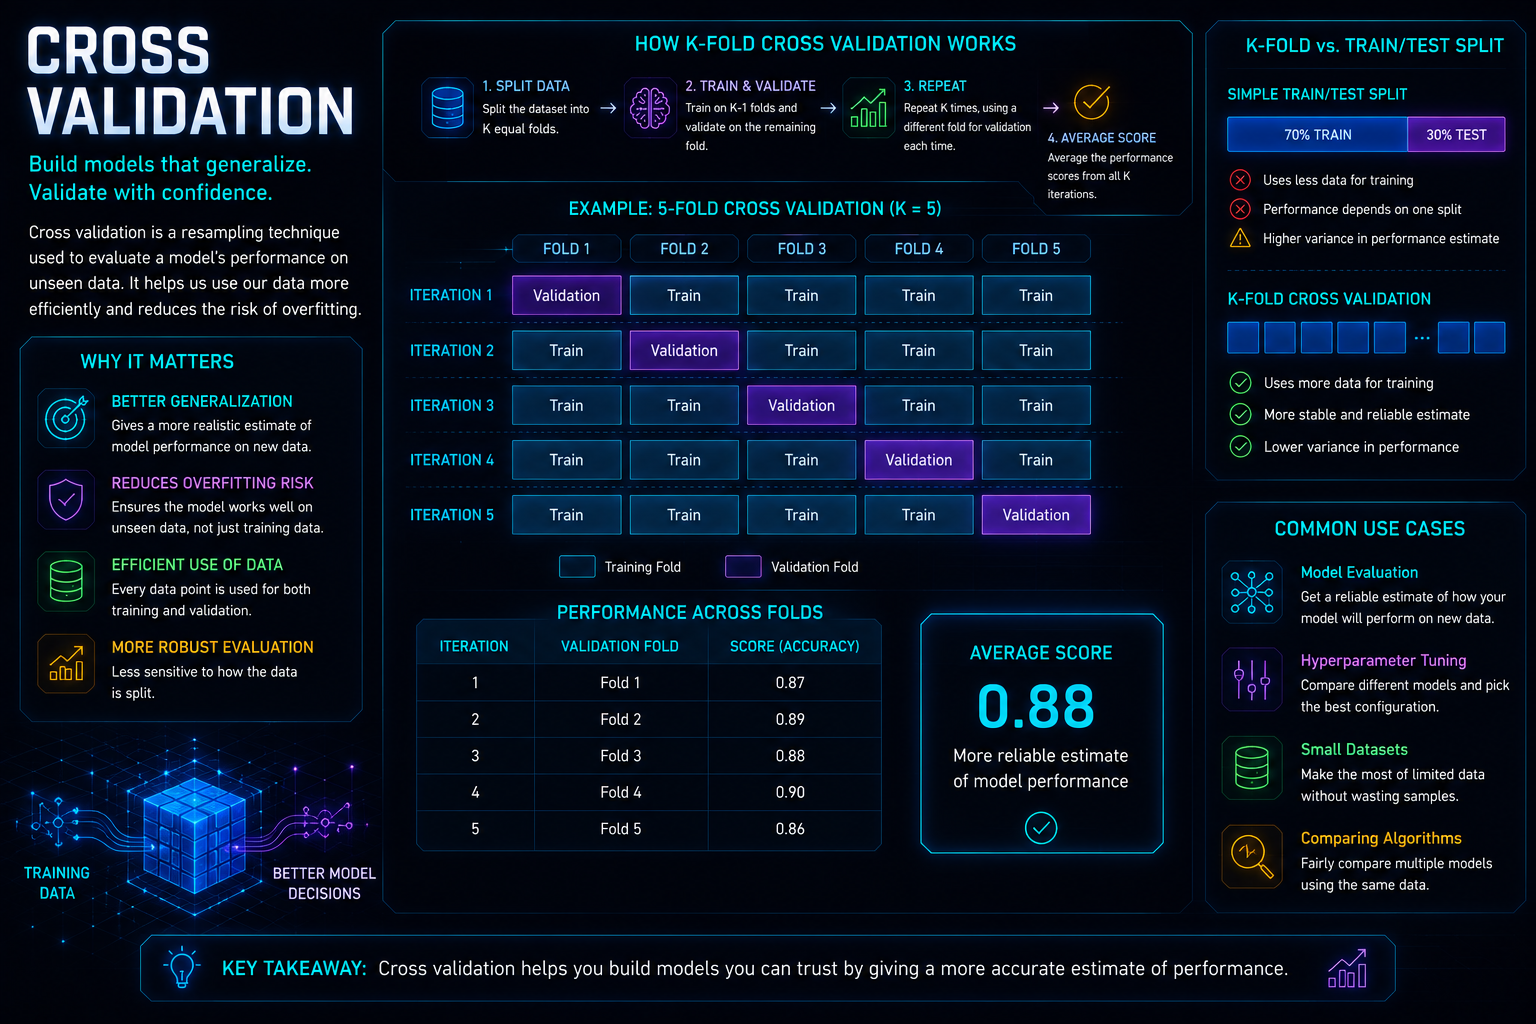
Walidacja krzyżowa
Walidacja krzyżowa to technika stosowana w celu sprawdzenia, jak dobrze model radzi sobie na różnych częściach zbioru danych. Zamiast przeprowadzać uczenie i testowanie tylko raz, dane są dzielone na kilka części. Pomaga to ustalić, czy model działa spójnie, czy też dobrze radzi sobie tylko w przypadku jednego, szczęśliwego podziału. Walidacja krzyżowa zmniejsza ryzyko przeszacowania rzeczywistej wydajności modelu.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
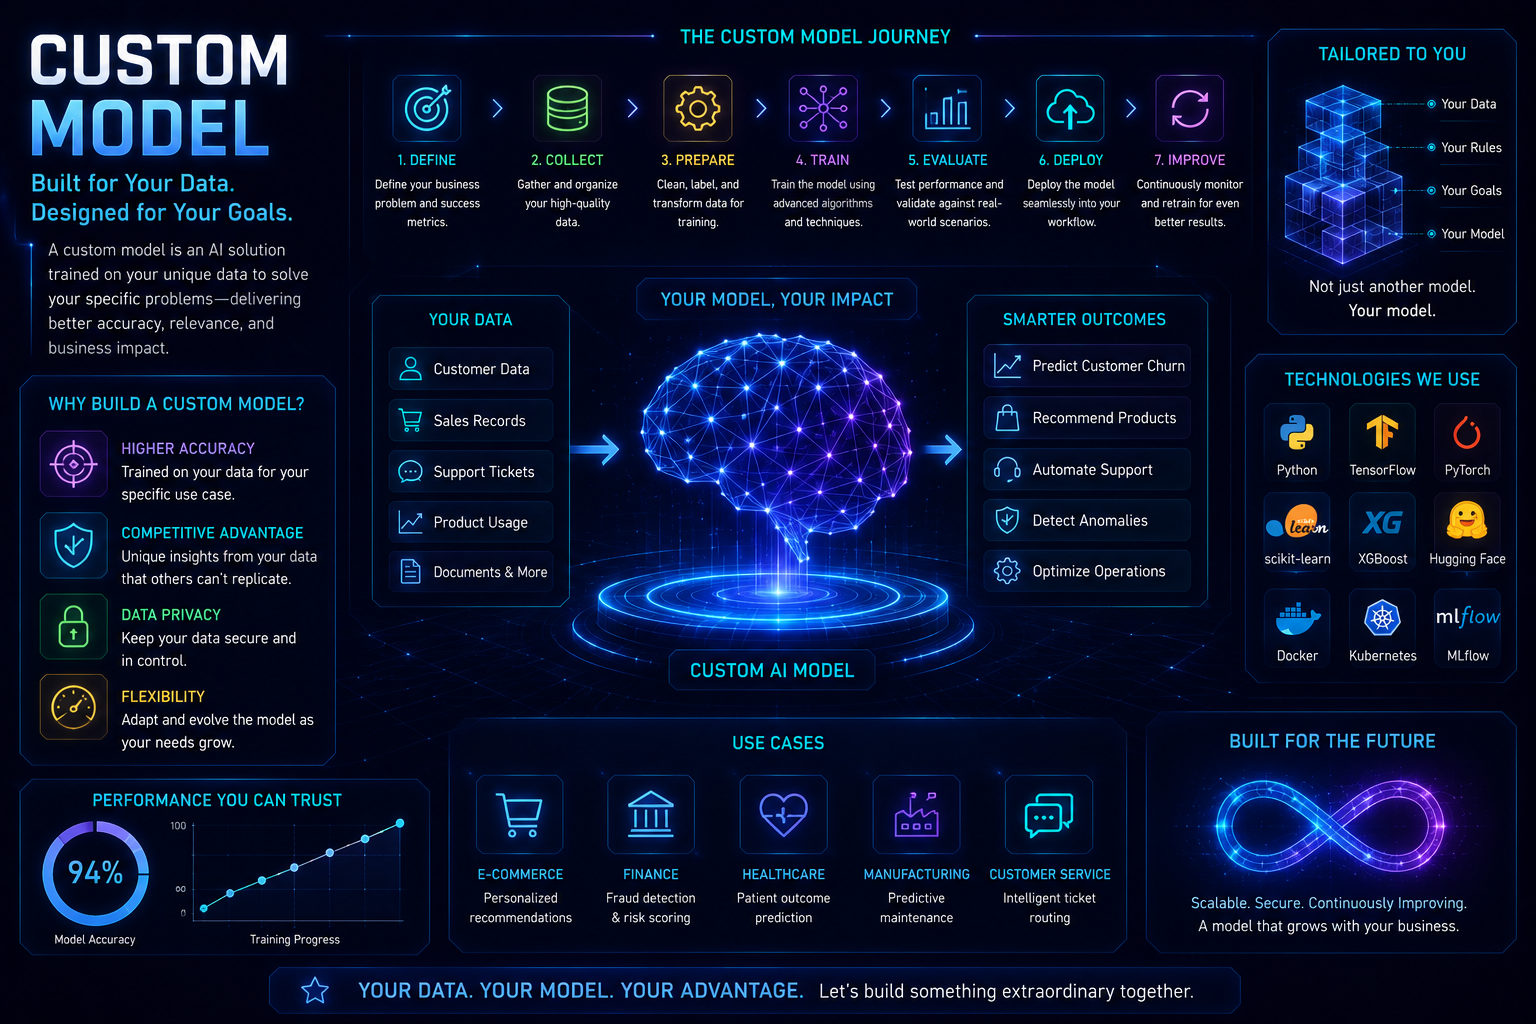
Model niestandardowy
Model niestandardowy to model sztucznej inteligencji dostosowany do konkretnej organizacji, zadania lub zbioru danych. Na przykład szpital może potrzebować modelu wytrenowanego na własnej dokumentacji medycznej, a kancelaria prawna – modelu dostosowanego do sporządzania dokumentów prawnych. Modele niestandardowe mogą być bardziej trafne niż modele ogólne, ale wymagają starannego postępowania z danymi, testowania i nadzoru.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
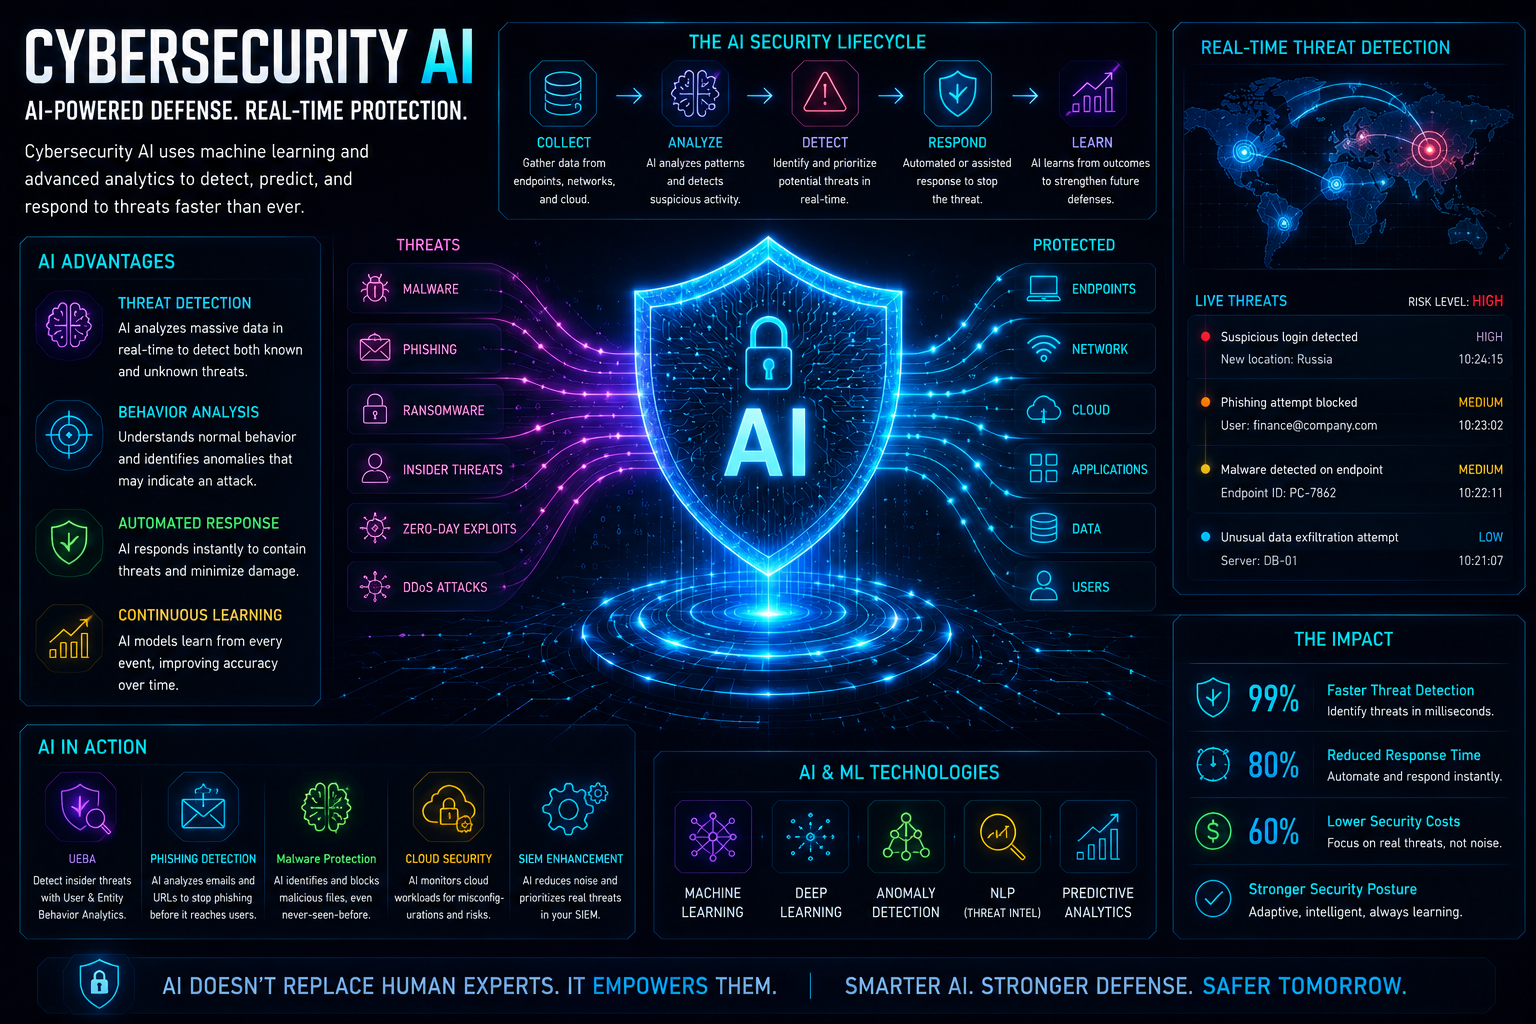
Sztuczna inteligencja w cyberbezpieczeństwie
Sztuczna inteligencja w cyberbezpieczeństwie wykorzystuje uczenie maszynowe i automatyzację do wykrywania, zapobiegania lub reagowania na zagrożenia cyfrowe. Może pomóc w wykrywaniu nietypowych zachowań w sieci, prób phishingu, złośliwego oprogramowania lub podejrzanych logowań. Jednocześnie osoby atakujące mogą również wykorzystywać sztuczną inteligencję do tworzenia bardziej przekonujących oszustw lub automatyzacji ataków. Sztuczna inteligencja jest zatem zarówno narzędziem obronnym, jak i nowym wyzwaniem w dziedzinie cyberbezpieczeństwa.
Ustaw The Portugal News jako preferowane źródło wiadomości w Google
 Dodaj jako preferowane źródło w Google








 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media