


 Crédits : image fournie ; Auteur : Stephen Whitelaw ;
Classification
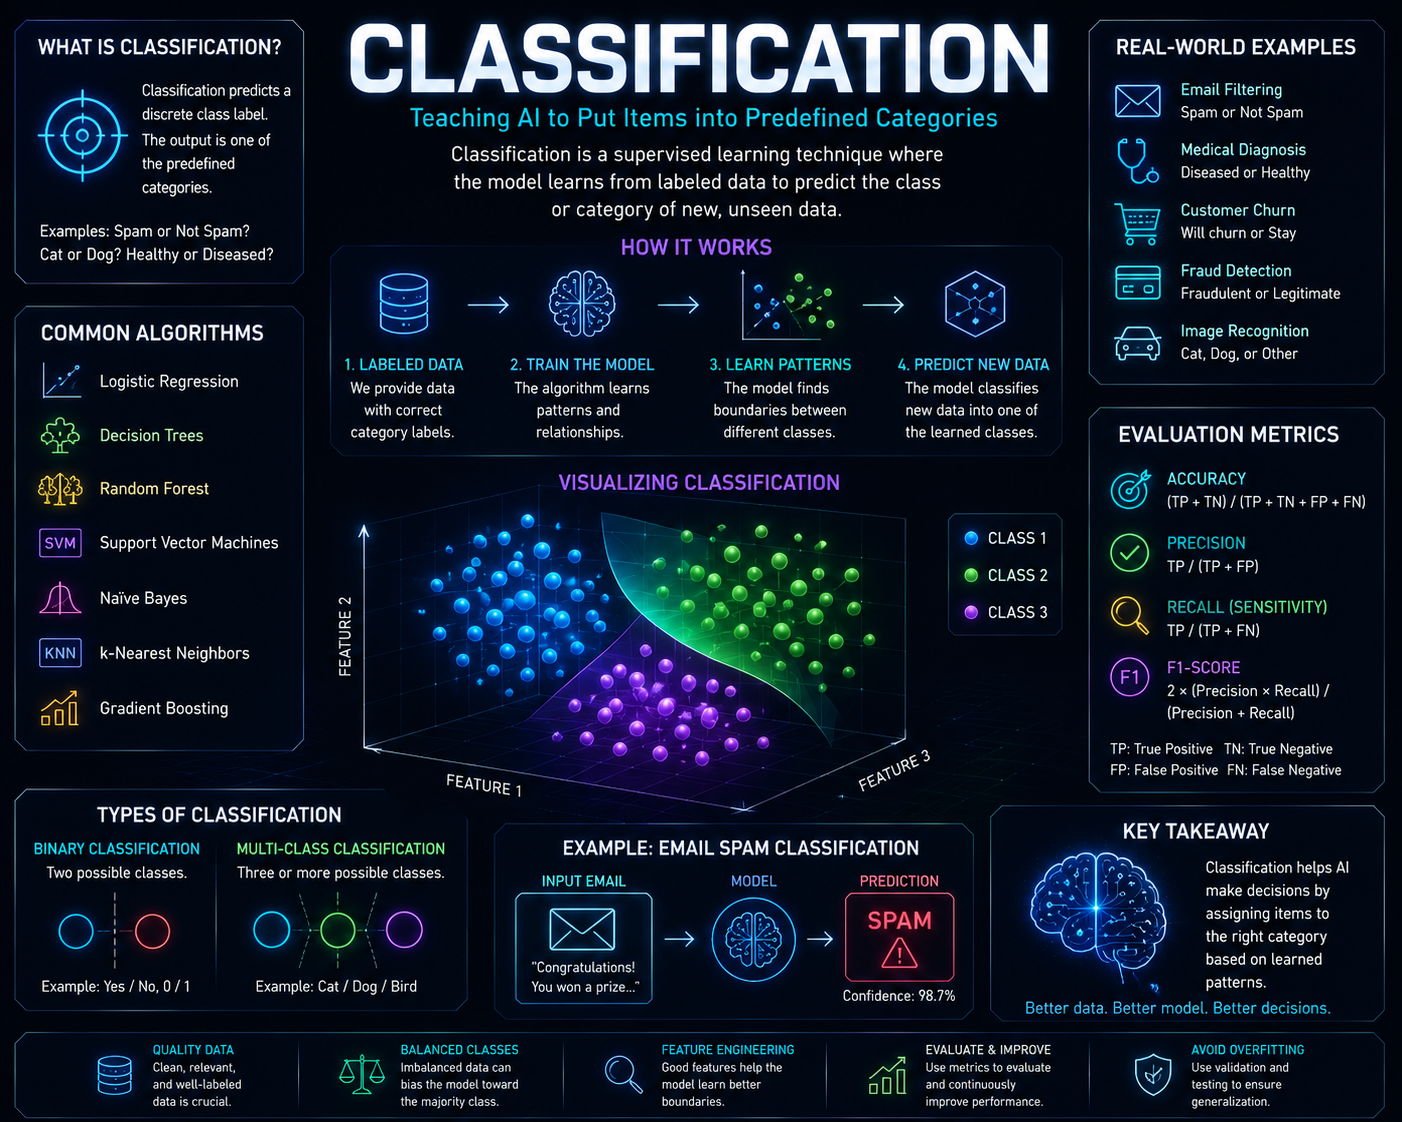
La classification est une tâche d'intelligence artificielle dans laquelle le système attribue un élément à une catégorie. Parmi les exemples, on peut citer le tri des e-mails en spam et non-spam, l'identification du caractère positif ou négatif d'un avis, ou encore la détection d'une radiographie normale ou anormale. La classification est l'une des utilisations les plus courantes de l'apprentissage automatique.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Claude
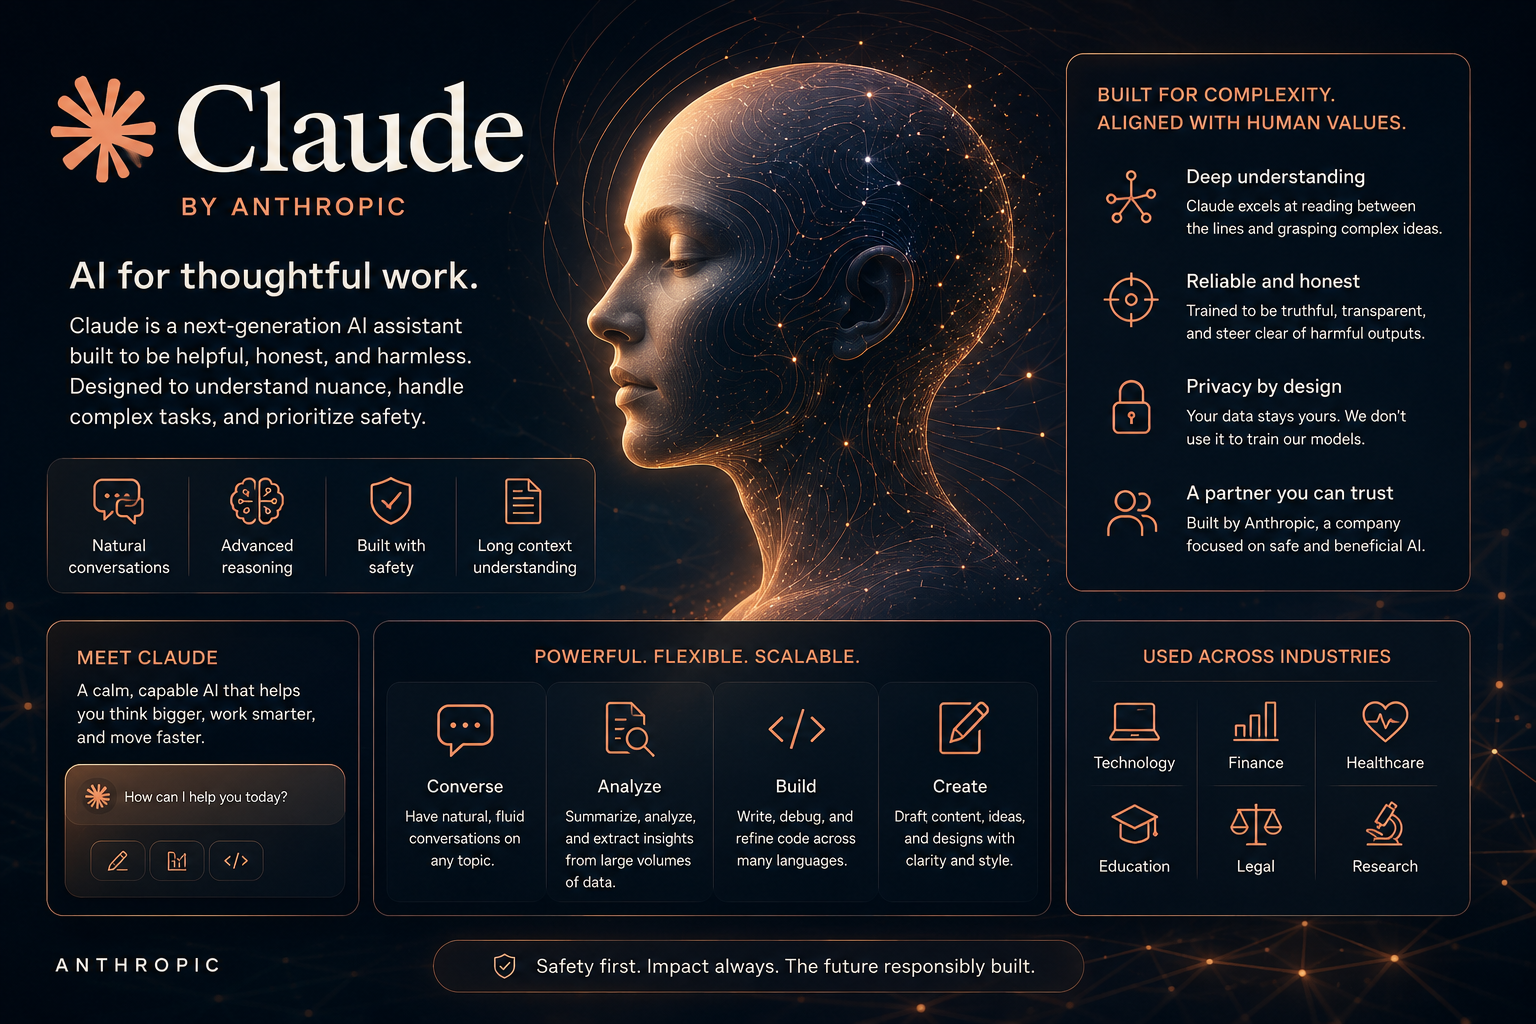
Claude est une famille avancée de grands modèles linguistiques développée par Anthropic. Conçue pour être sûre, précise et sécurisée, elle comprend des outils spécialisés tels que Claude Code (un outil de codage agentique), Claude Design et Claude Science pour la recherche. Claude doit son nom au célèbre Claude Shannon, mathématicien, informaticien et père de la théorie de l'information.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
IA dans le cloud
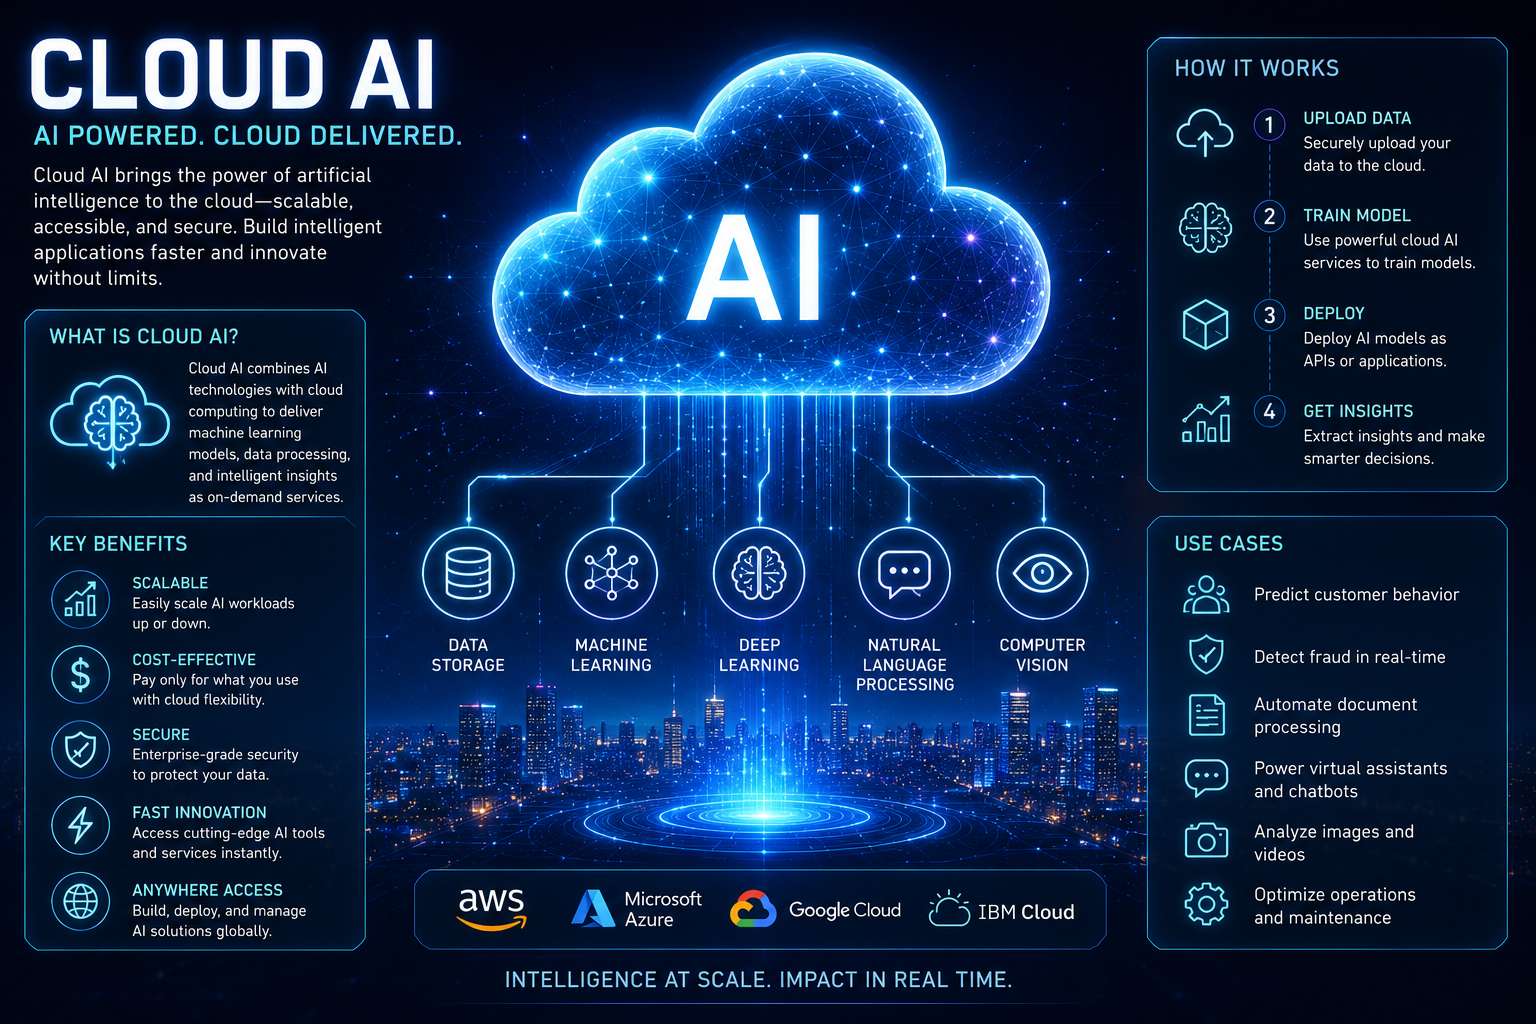
Le terme « Cloud AI » désigne les services d’IA fournis via Internet par de grands fournisseurs de services informatiques. Au lieu d’acheter du matériel coûteux, les entreprises peuvent accéder à des modèles d’IA, à des capacités de stockage et à de la puissance de calcul via des plateformes cloud. Cela rend l’IA plus accessible, mais soulève également des questions concernant la confidentialité des données, la sécurité, les coûts et la dépendance vis-à-vis des grandes entreprises technologiques.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
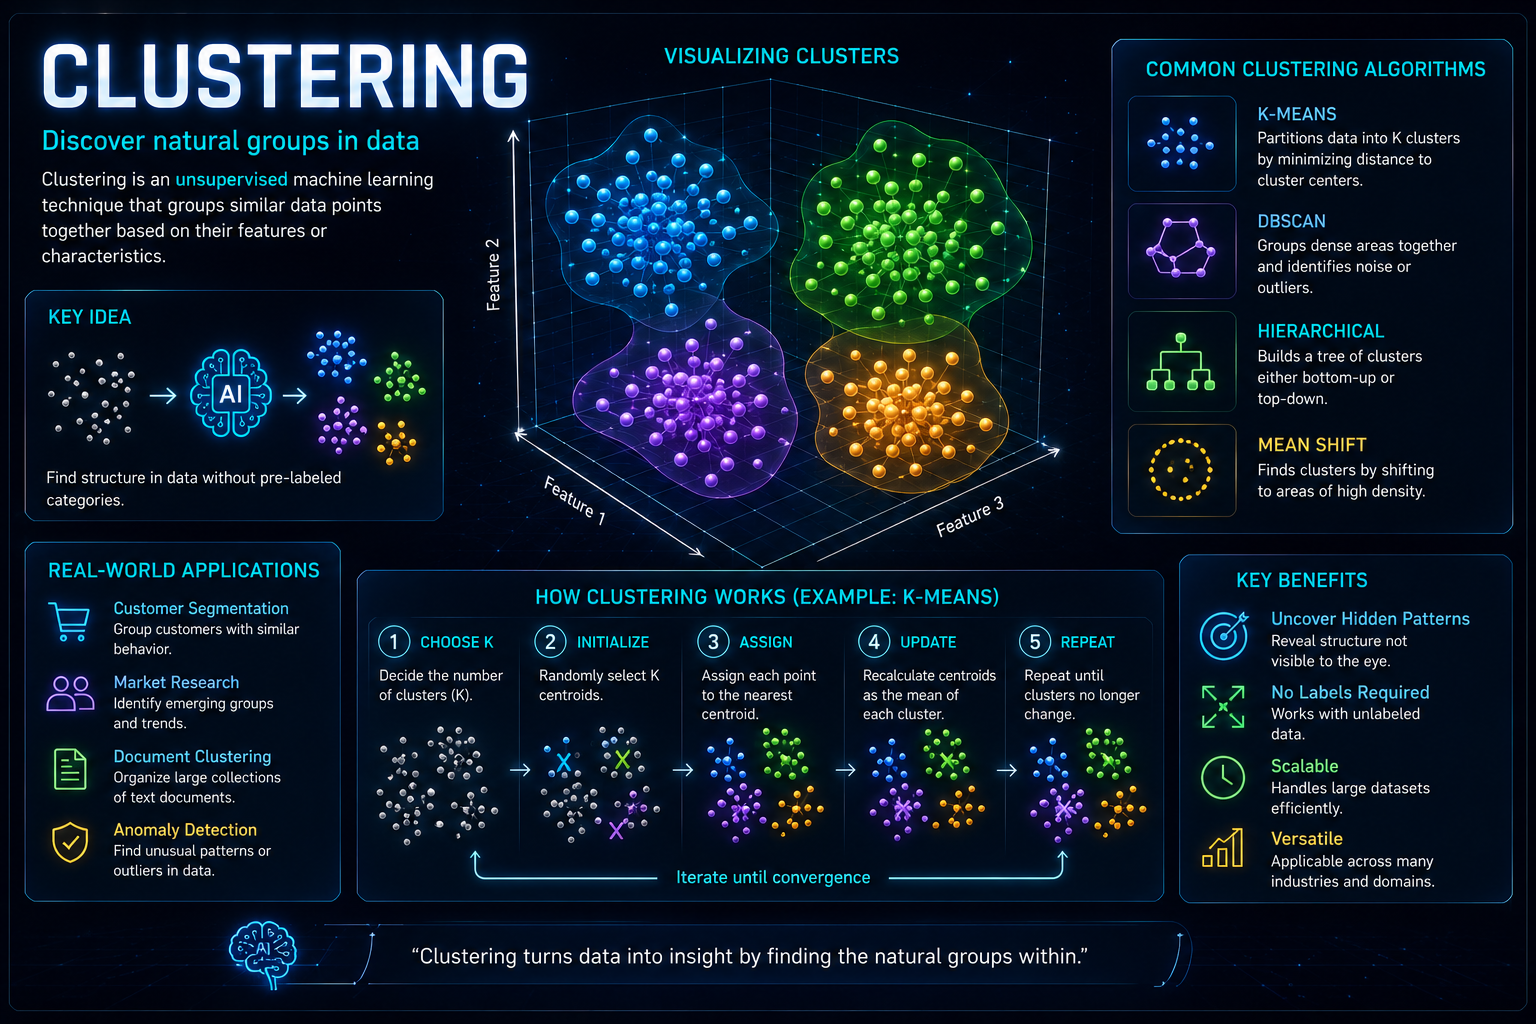
Le clustering
Le clustering est une méthode d’apprentissage automatique qui regroupe des éléments similaires sans qu’on lui indique au préalable les catégories correctes. Par exemple, un détaillant peut utiliser le clustering pour identifier des groupes de clients ayant des habitudes d’achat similaires. Le clustering est utile pour découvrir des tendances, mais les groupes qu’il identifie doivent encore faire l’objet d’une interprétation humaine.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
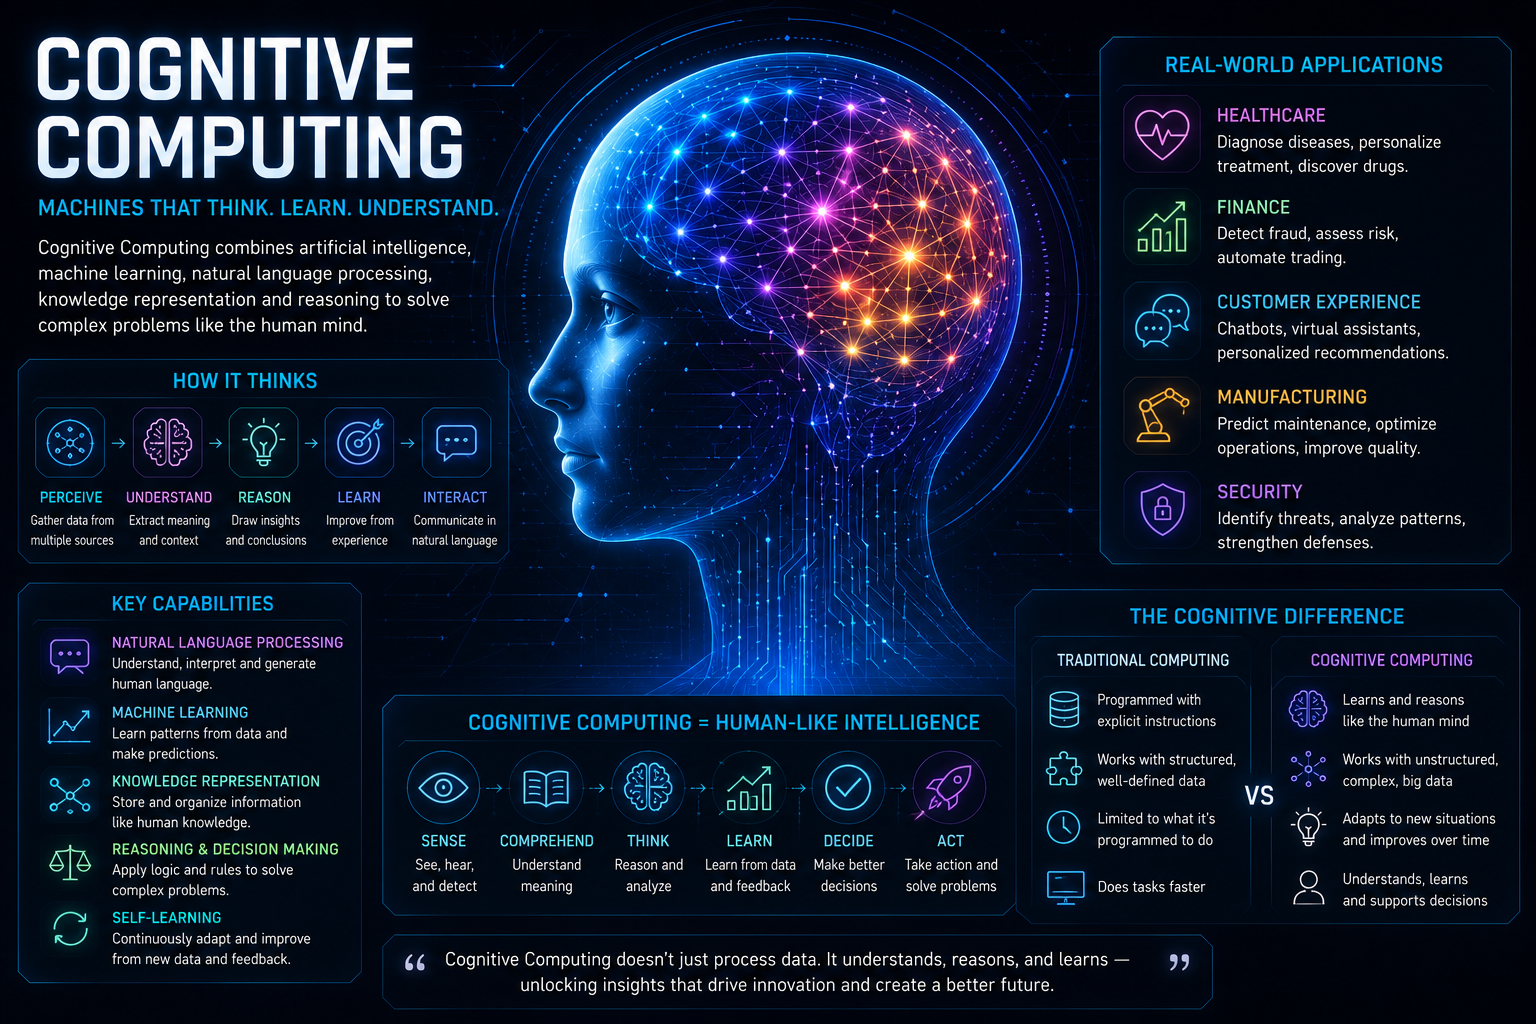
Informatique cognitive
L'informatique cognitive est un terme plus ancien et plus large désignant les systèmes conçus pour imiter certains aspects de la pensée humaine, tels que l'apprentissage, le raisonnement et la compréhension du langage. Il est souvent utilisé dans des contextes professionnels. Aujourd'hui, on parle plus couramment d'IA, d'apprentissage automatique et d'IA générative, mais l'idée de base reste la même : utiliser des ordinateurs pour prendre en charge des tâches complexes de type humain.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
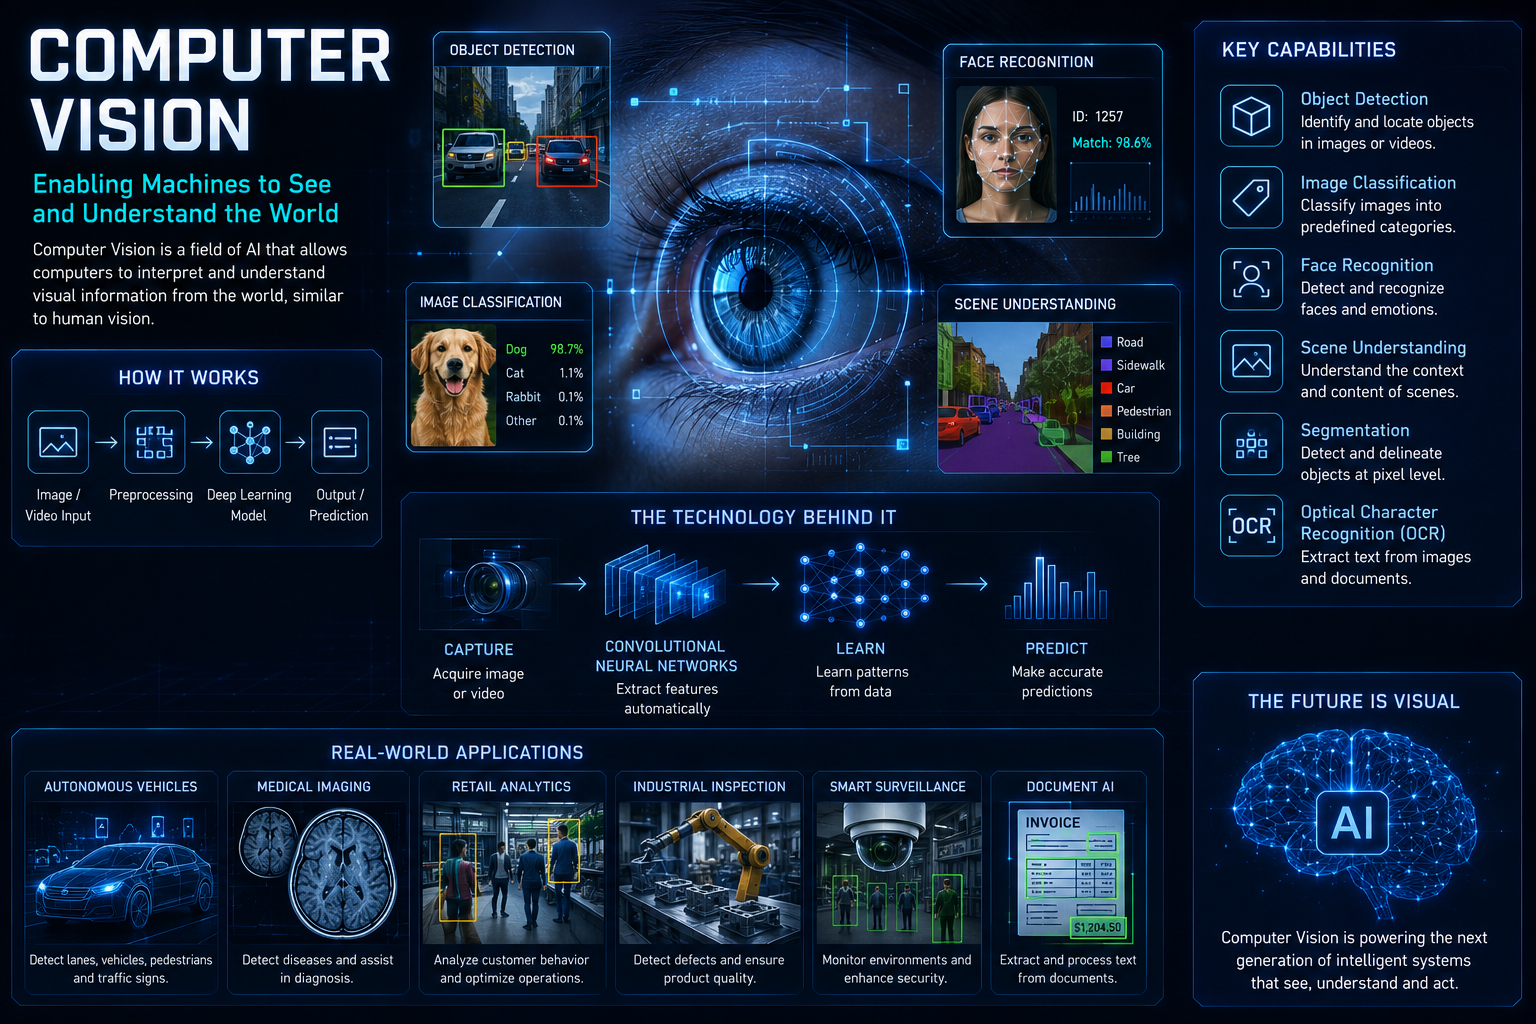
Vision par ordinateur
La vision par ordinateur est la branche de l’IA qui aide les ordinateurs à interpréter les images et les vidéos. Elle est utilisée dans l’imagerie médicale, la reconnaissance faciale, les voitures autonomes, le contrôle qualité, l’agriculture, la sécurité et l’analyse sportive. Les systèmes de vision par ordinateur peuvent être puissants, mais ils peuvent échouer lorsque l’éclairage, les angles, les arrière-plans ou les conditions réelles diffèrent des données d’entraînement.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
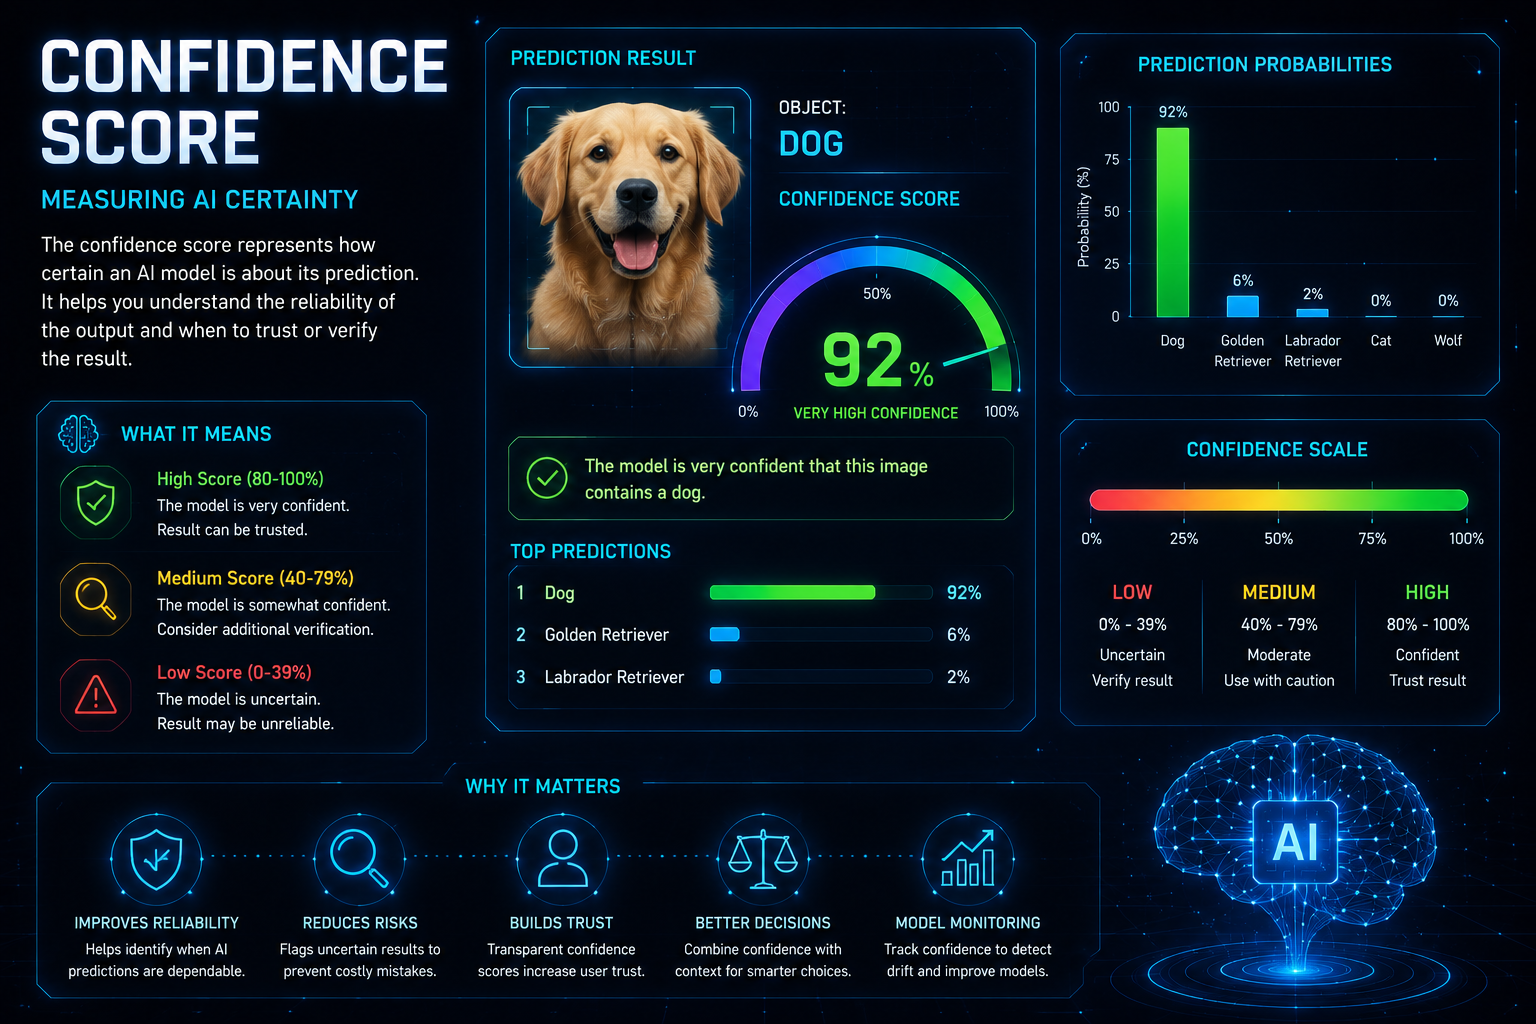
Score de confiance
Un score de confiance est un chiffre indiquant dans quelle mesure un système d’IA est sûr de son résultat. Par exemple, un classificateur d’images peut indiquer qu’il est sûr à 92 % qu’une photo représente un chien. Les scores de confiance peuvent être utiles, mais ils ne constituent pas des garanties. Certains systèmes d’IA font preuve d’une confiance excessive même lorsqu’ils se trompent, d’où l’importance de l’étalonnage et des tests.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Fenêtre de contexte
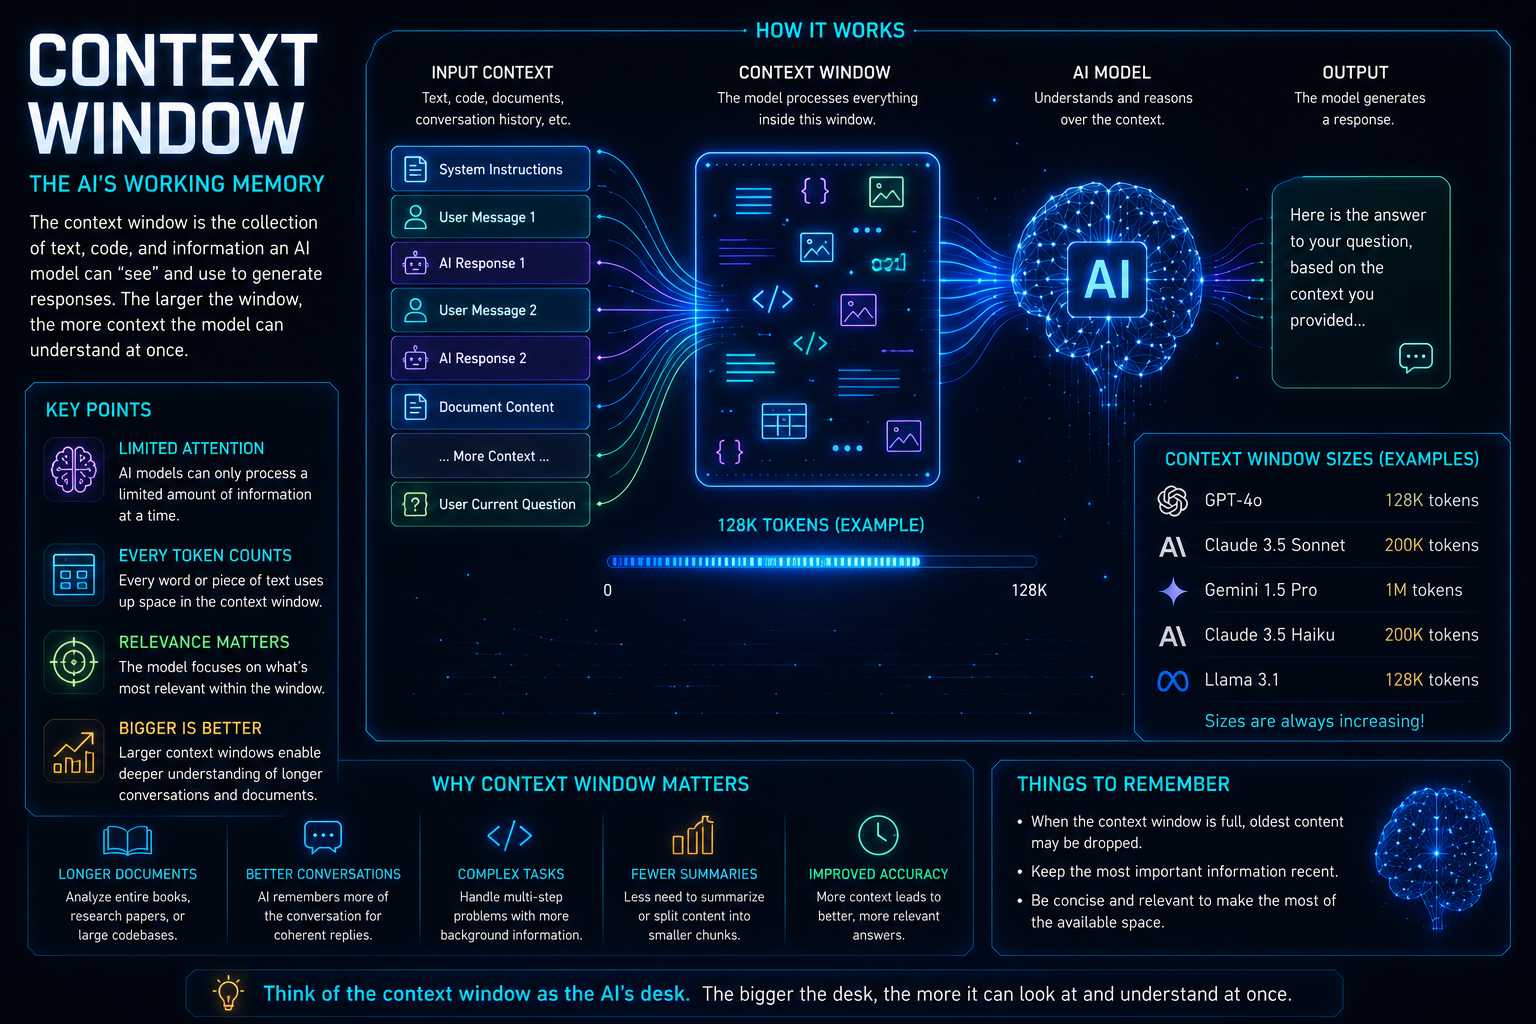
La fenêtre de contexte correspond à la quantité d’informations qu’un modèle linguistique peut prendre en compte simultanément. Elle peut inclure la question de l’utilisateur, la conversation précédente, du texte téléchargé ou des documents récupérés. Une fenêtre de contexte plus large permet au modèle de traiter des documents plus longs et davantage d’informations contextuelles. Cependant, même avec une grande fenêtre de contexte, le modèle peut encore passer à côté de certains détails ou privilégier certaines informations par rapport à d’autres. De nombreux acteurs du secteur estiment que nous nous dirigeons vers des fenêtres de contexte infinies – c’est-à-dire un système dont l’utilisateur n’aura plus à se soucier.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Réseau neuronal convolutif
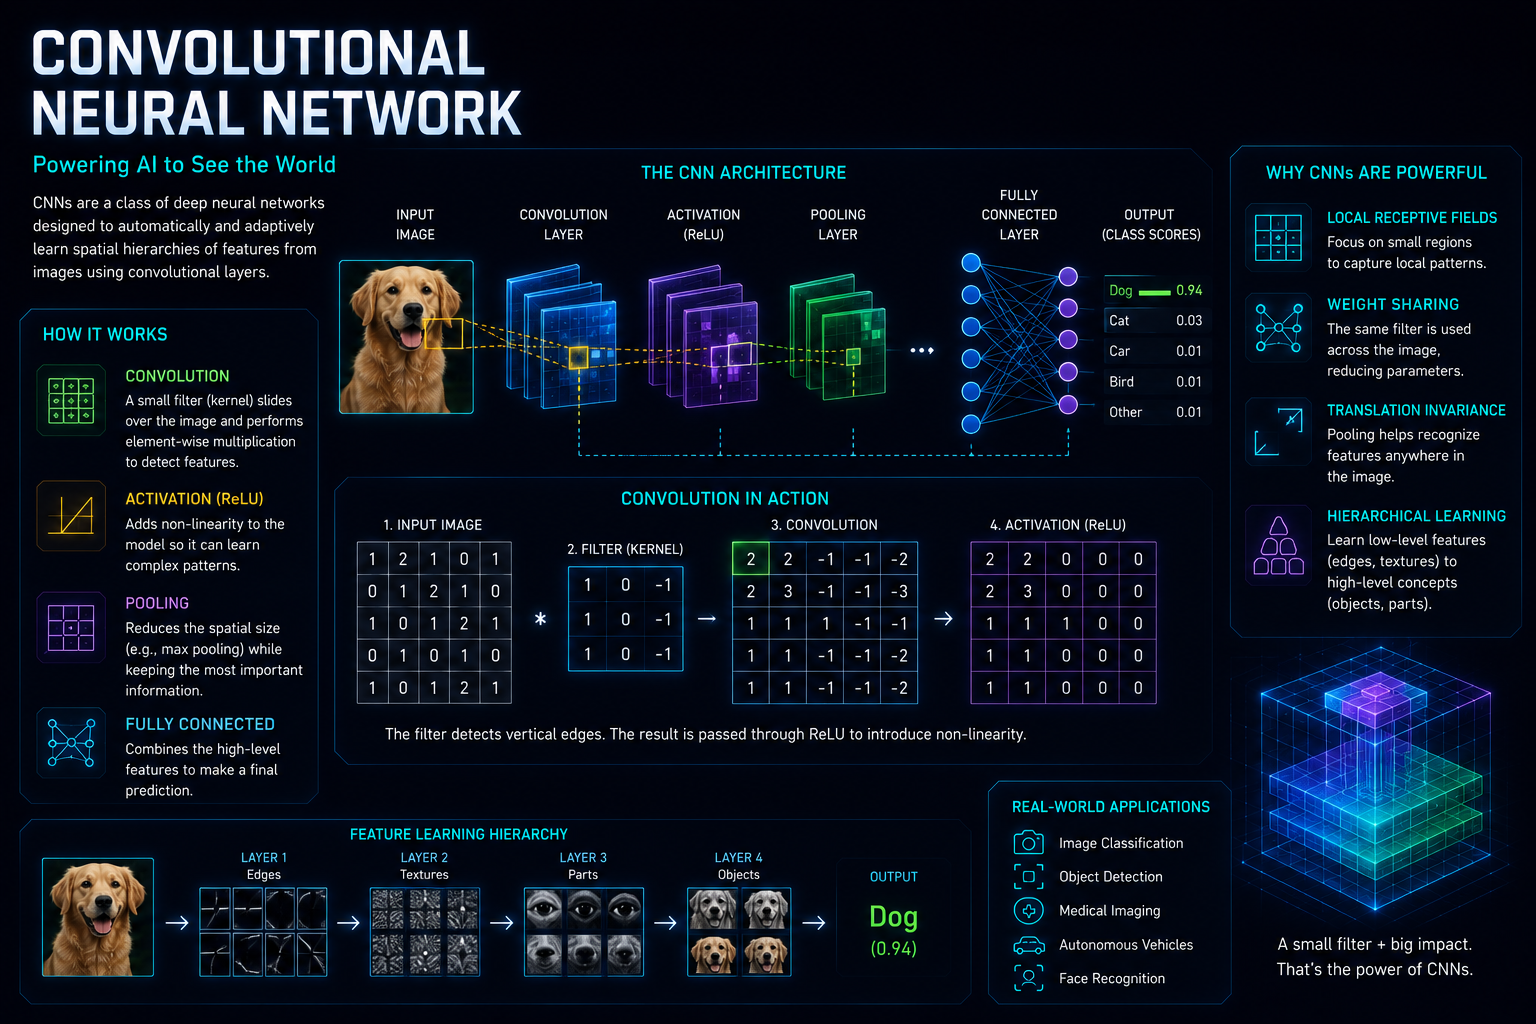
Un réseau neuronal convolutif, ou CNN, est un type de réseau neuronal particulièrement utile pour les images. Les CNN détectent des motifs tels que les contours, les formes, les textures et les objets. Ils ont joué un rôle majeur dans l’essor de la vision par ordinateur. Bien que des architectures plus récentes soient désormais également utilisées, les CNN restent importants dans l’analyse d’images, l’imagerie médicale et la reconnaissance visuelle.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Corpus
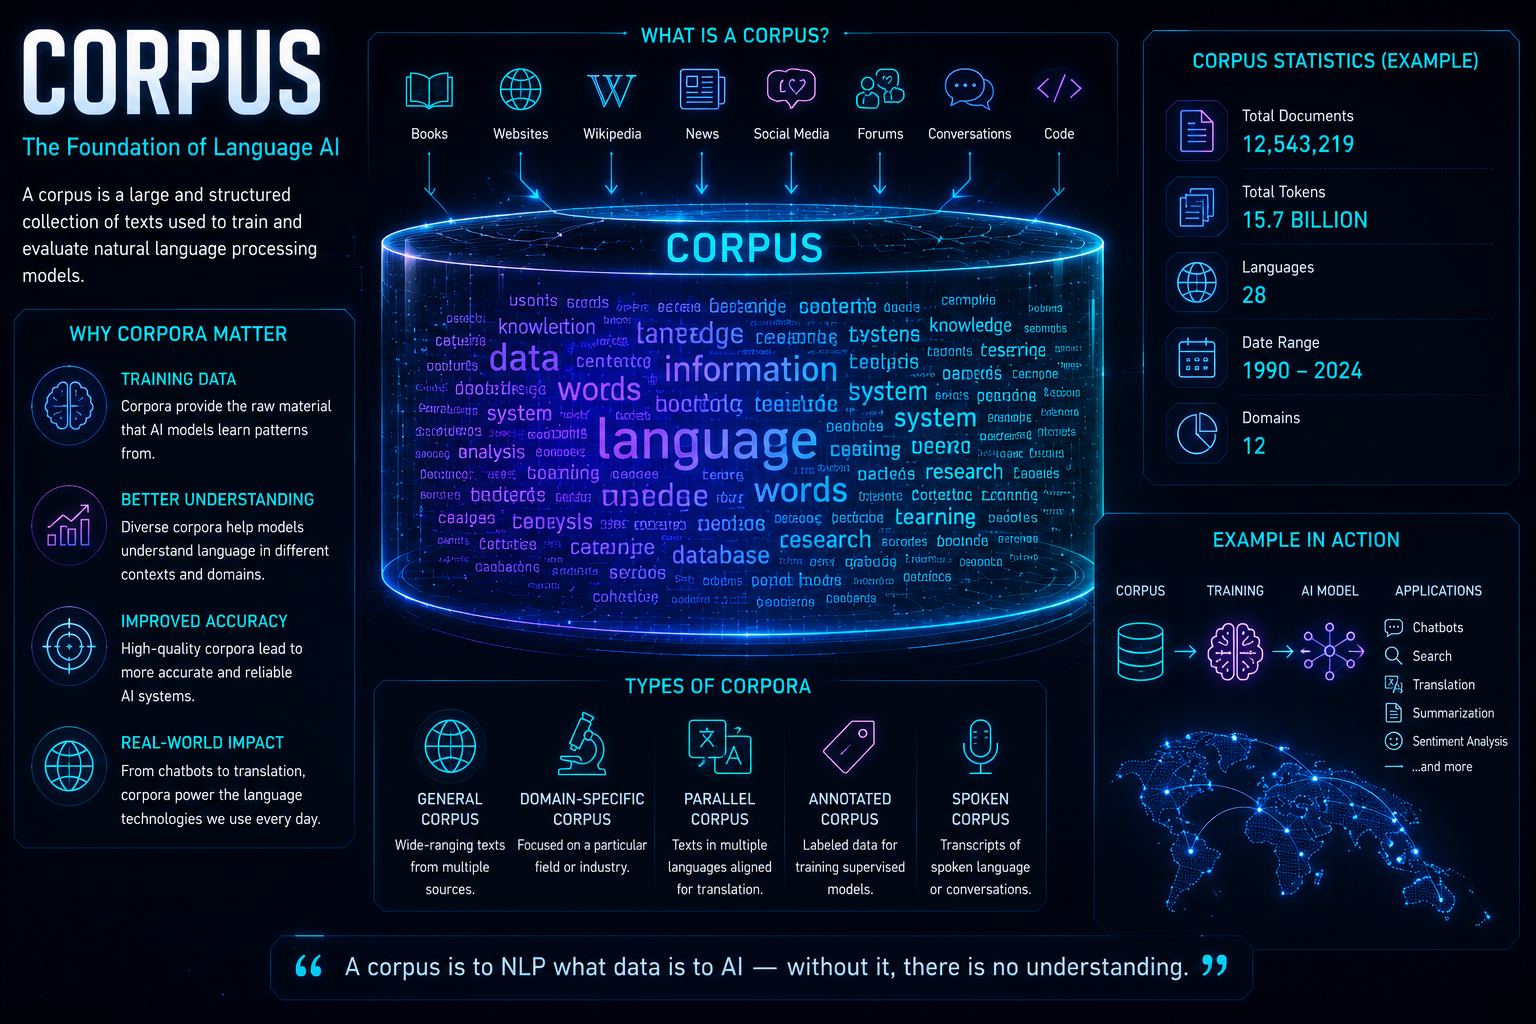
Un corpus est un ensemble de textes ou de données utilisé à des fins d’analyse ou d’apprentissage. Par exemple, un modèle linguistique peut être entraîné sur un corpus contenant des livres, des articles, des sites web, du code et d’autres documents écrits. La qualité et la composition du corpus influencent fortement le comportement du modèle. Si le corpus contient des erreurs, des biais ou des informations obsolètes, le modèle risque de les assimiler également.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Fonction de coût
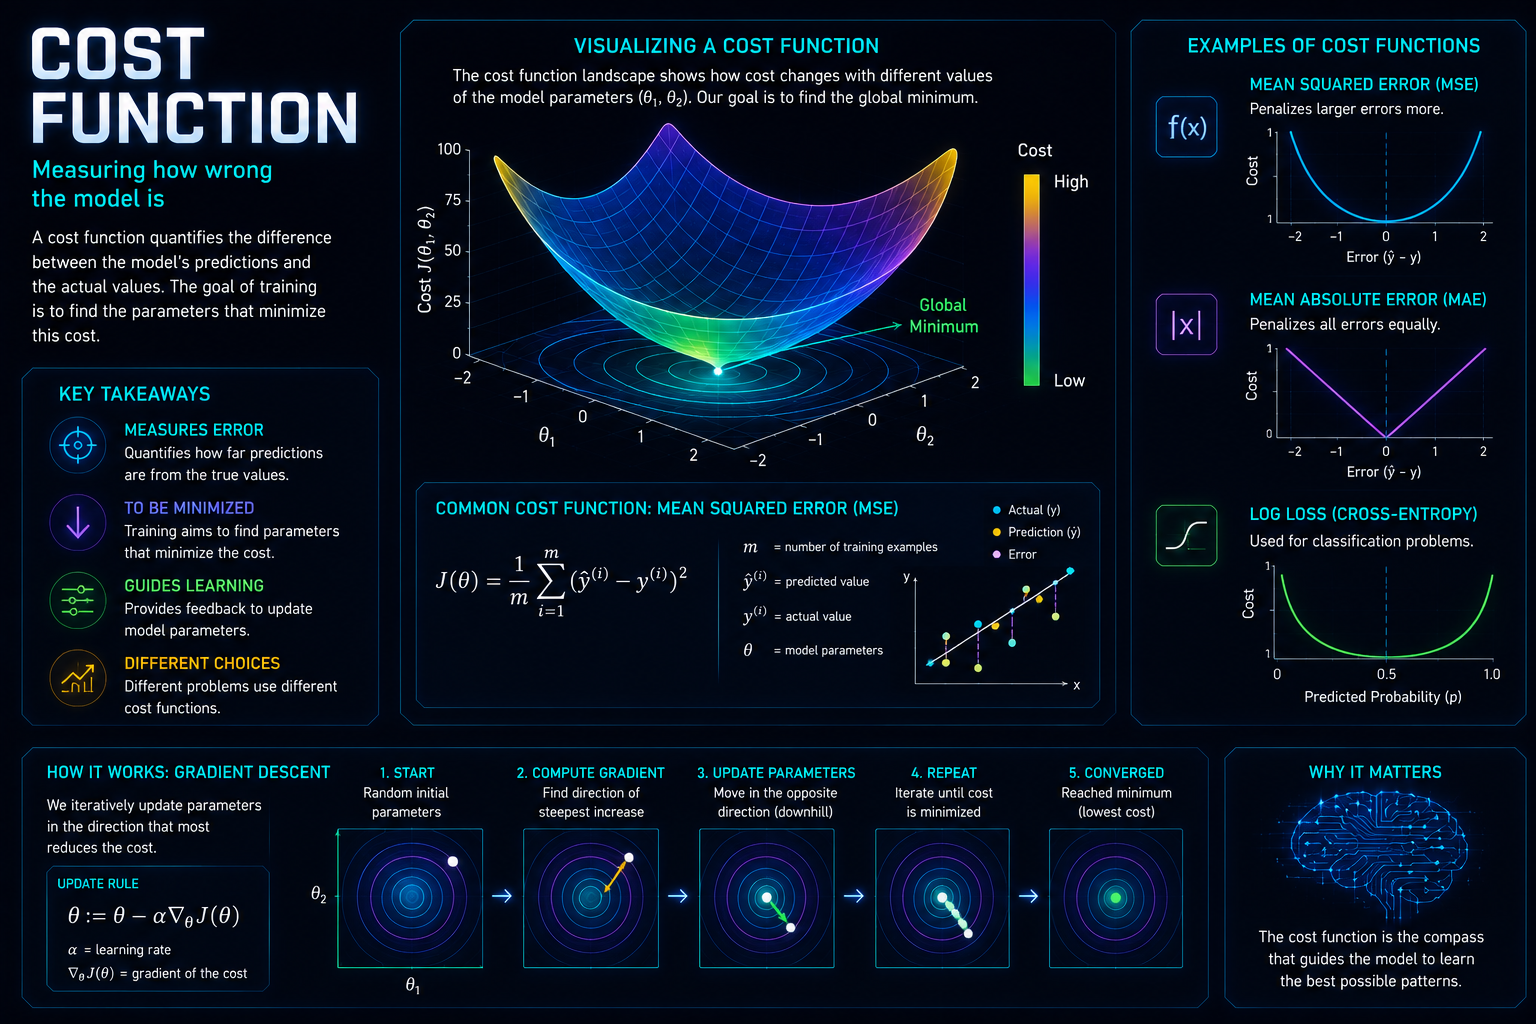
Une fonction de coût, également appelée fonction de perte, mesure le degré d’erreur d’un modèle pendant l’apprentissage. Le modèle s’efforce de réduire cette erreur au fil du temps. Par exemple, si une IA prédit les prix de l’immobilier, la fonction de coût mesure la différence entre les prix prédits et les prix réels. L’apprentissage consiste essentiellement à ajuster le modèle afin de minimiser cette perte.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
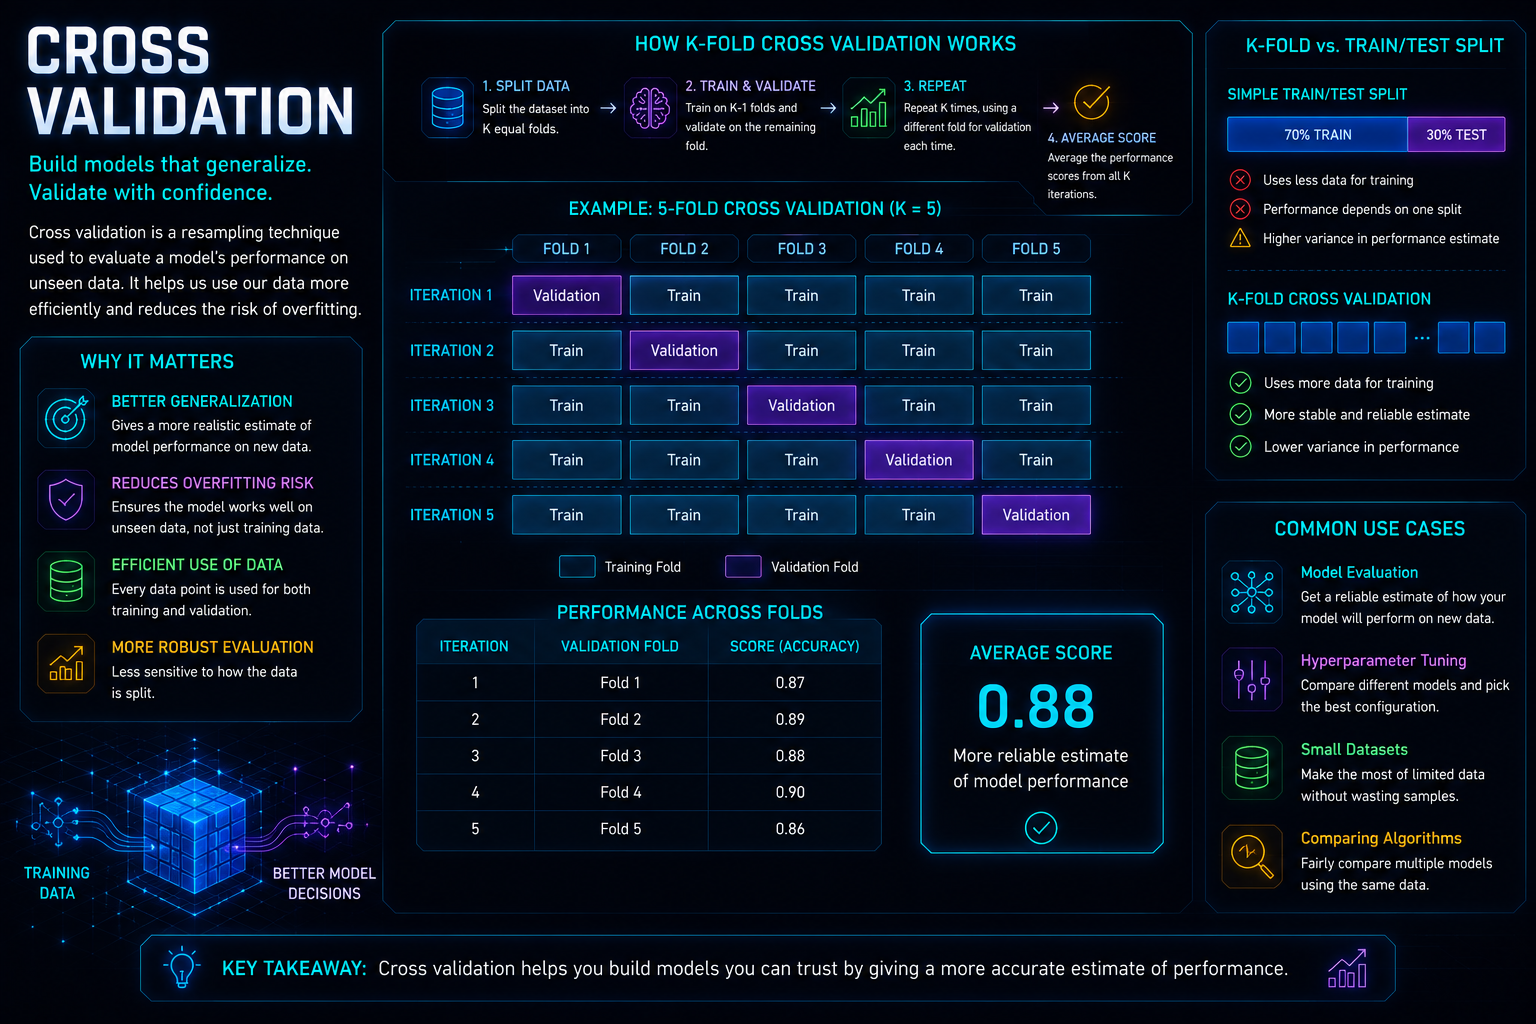
Validation croisée
La validation croisée est une technique utilisée pour tester les performances d’un modèle sur différentes parties des données. Au lieu de ne procéder qu’à un seul cycle d’apprentissage et de test, les données sont divisées de plusieurs façons. Cela permet de déterminer si le modèle offre des performances constantes ou s’il ne fonctionne bien que sur un seul découpage, par hasard. La validation croisée réduit le risque de surestimer les performances réelles d’un modèle.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
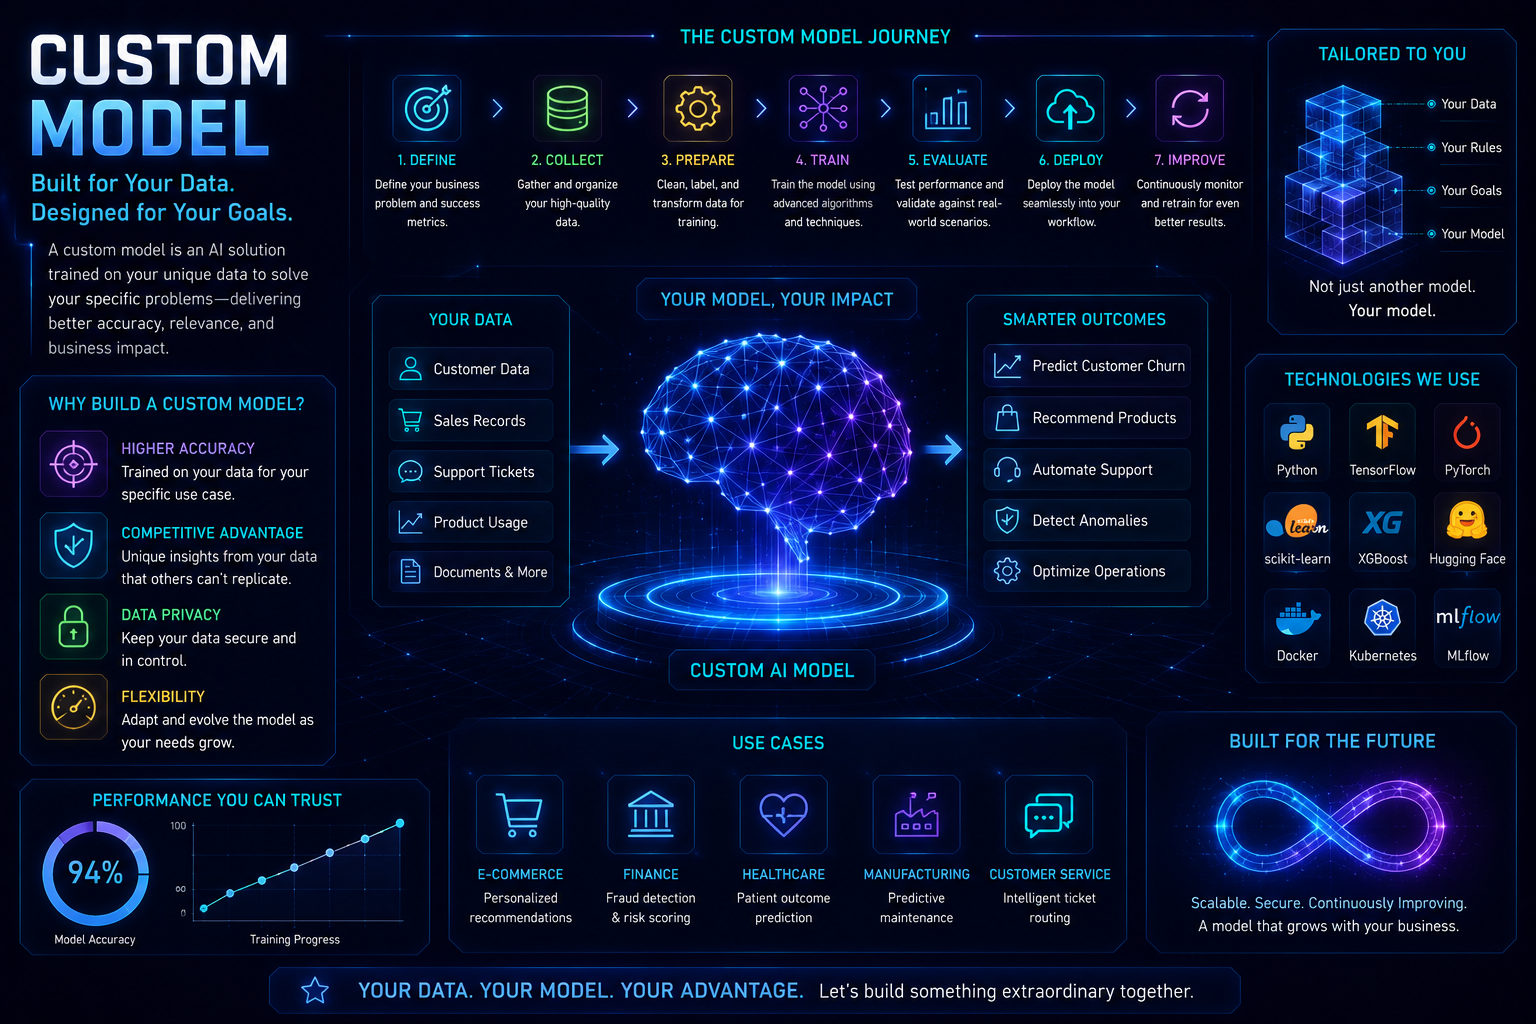
Modèle sur mesure
Un modèle sur mesure est un modèle d’IA adapté à une organisation, une tâche ou un ensemble de données spécifiques. Par exemple, un hôpital peut souhaiter un modèle entraîné sur ses propres documents cliniques, ou un cabinet d’avocats peut en vouloir un optimisé pour la rédaction juridique. Les modèles sur mesure peuvent être plus pertinents que les modèles généraux, mais ils nécessitent un traitement, des tests et une gouvernance rigoureux des données.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
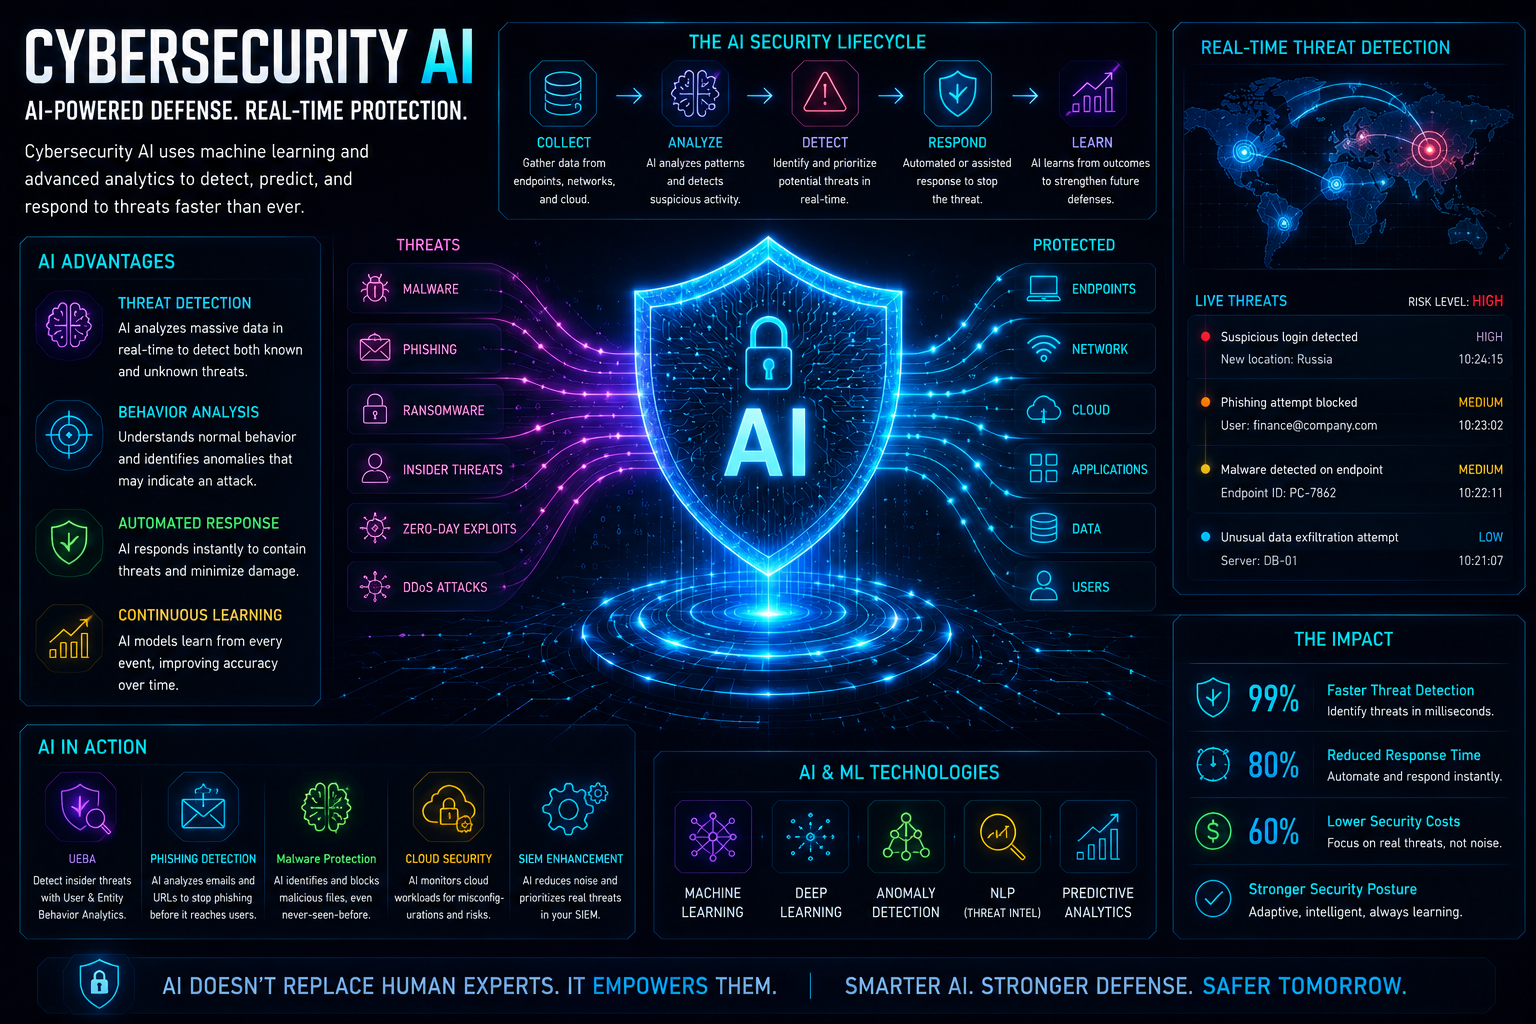
IA appliquée à la cybersécurité
L’IA appliquée à la cybersécurité utilise l’apprentissage automatique et l’automatisation pour détecter, prévenir ou répondre aux menaces numériques. Elle peut aider à repérer les comportements réseau inhabituels, les tentatives d’hameçonnage, les logiciels malveillants ou les connexions suspectes. Parallèlement, les pirates peuvent également utiliser l’IA pour concevoir des escroqueries plus convaincantes ou automatiser leurs attaques. L’IA constitue donc à la fois un outil défensif et un nouveau défi en matière de cybersécurité.
Définissez The Portugal News comme votre source d'actualités préférée sur Google
 Ajouter comme source préférée sur Google








 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media