


 Bildnachweis: Bild zur Verfügung gestellt; Autor: Stephen Whitelaw;
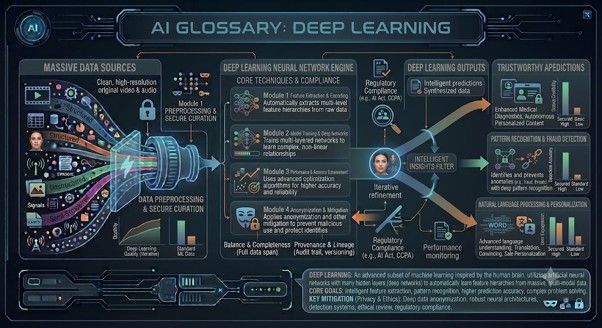
Deep Learning
Deep Learning ist eine Form des maschinellen Lernens, die auf mehrschichtigen neuronalen Netzen basiert. Diese Systeme können komplexe Muster in Bildern, Texten, Audio- und Videodaten erkennen. Deep Learning ist die Grundlage für viele moderne Durchbrüche im Bereich der KI, darunter Spracherkennung, Bildgenerierung, Übersetzung und große Sprachmodelle. Oft sind dafür große Datenmengen und hohe Rechenleistung erforderlich.
 Bildnachweis: Bild zur Verfügung gestellt; Autor: Stephen Whitelaw;
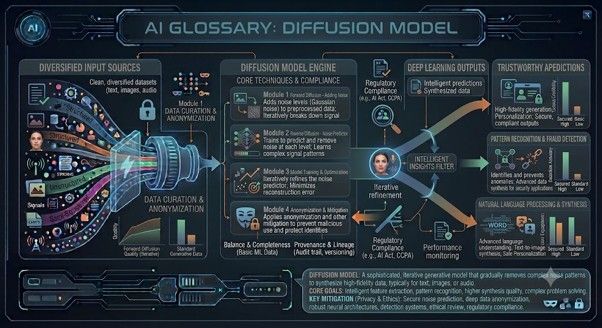
Diffusionsmodell
Ein Diffusionsmodell ist eine Form generativer KI, die häufig zur Erstellung von Bildern verwendet wird. Es lernt, Daten zu generieren, indem es mit Rauschen beginnt und dieses schrittweise zu einem zusammenhängenden Bild oder Ergebnis verfeinert. Viele moderne Tools zur Bildgenerierung nutzen Diffusionstechniken. Das Ergebnis kann je nach Eingabe und Modell sehr realistisch oder künstlerisch sein.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
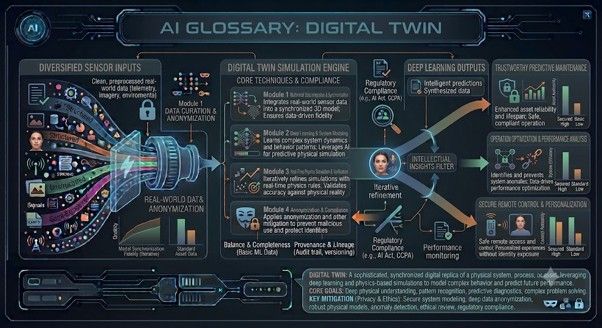
Digitaler Zwilling
Ein digitaler Zwilling ist ein virtuelles Modell eines realen Objekts, Systems oder Prozesses. Beispielsweise könnte eine Fabrik über einen digitalen Zwilling verfügen, der Maschinen, Energieverbrauch und Produktionsablauf simuliert. KI kann digitale Zwillinge leistungsfähiger machen, indem sie Probleme vorhersagt und Änderungen testet, bevor diese in der realen Welt eintreten. Digitale Zwillinge kommen im Ingenieurwesen, im Gesundheitswesen, im Verkehrswesen und in Smart Cities zum Einsatz.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
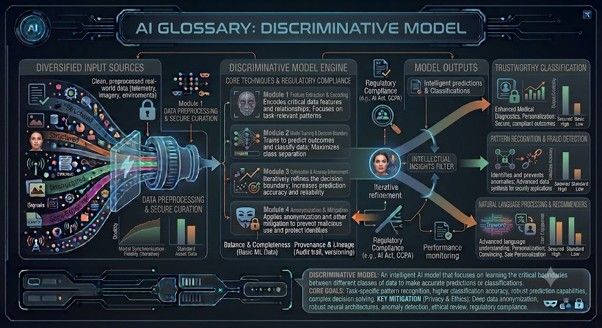
Diskriminatives Modell
Ein diskriminatives Modell lernt, zwischen Kategorien zu unterscheiden. Es kann beispielsweise entscheiden, ob eine E-Mail Spam ist oder nicht, oder ob ein Tumorbild gutartig oder bösartig erscheint. Diskriminative Modelle unterscheiden sich von generativen Modellen, die neue Inhalte erzeugen. Vereinfacht ausgedrückt: Diskriminative Modelle klassifizieren, generative Modelle produzieren.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
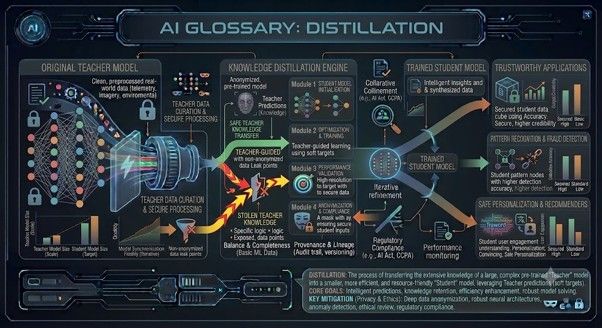
Destillation
Bei der KI-Destillation wird ein kleines, schnelles KI-Modell so trainiert, dass es das Wissen und das Verhalten eines großen, intelligenten KI-Modells kopiert. Stellen Sie sich das so vor, als würde ein Meisterkoch (das große Modell) einem Lehrling (dem kleinen Modell) all seine Geheimrezepte und Techniken beibringen, damit der Lehrling Gerichte in derselben Qualität zubereiten kann – nur viel schneller und mit weniger Küchenutensilien.Warum es eingesetzt wird: Spart Platz: Es verkleinert riesige KI-Systeme, sodass sie auf ein Smartphone oder einen Laptop passen. Spart Geld: Der Betrieb des kleineren Modells erfordert deutlich weniger Rechenleistung. Spart Zeit: Das kleinere Modell liefert Antworten viel schneller als das riesige.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
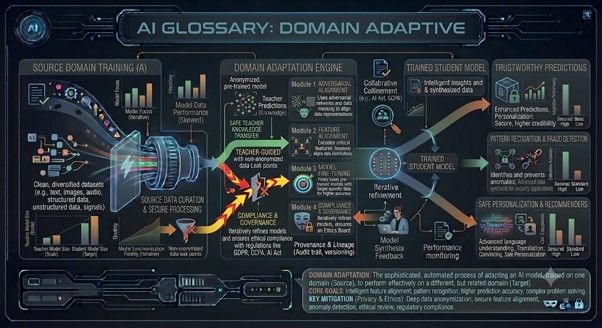
Domänenanpassung
Domänenanpassung ist der Prozess, bei dem ein KI-Modell so angepasst wird, dass es in einem neuen, aber verwandten Umfeld gut funktioniert. Beispielsweise funktioniert ein Modell, das anhand von Krankenhausdaten aus einem Land trainiert wurde, in einem anderen Land möglicherweise nicht ebenso gut, da sich Geräte, Patienten oder Verfahren unterscheiden. Die Domänenanpassung hilft Modellen dabei, Wissen zu übertragen und sich gleichzeitig an lokale Bedingungen anzupassen.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
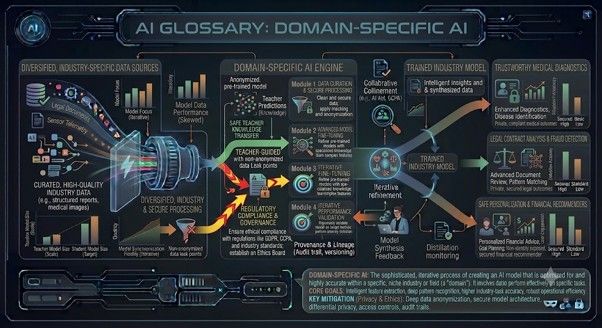
Domänenspezifische KI
Domänenspezifische KI ist KI, die für einen bestimmten Bereich entwickelt wurde, wie zum Beispiel das Gesundheitswesen, das Rechtswesen, den Finanzsektor, das Bildungswesen, die Landwirtschaft oder die Fertigungsindustrie. Diese Systeme können präziser und nützlicher sein als allgemeine Tools, da sie auf Fachwissen und spezifischen Arbeitsabläufen basieren. Domänenspezifische KI erfordert jedoch die Aufsicht durch Experten, da Fehler schwerwiegende Folgen haben können.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
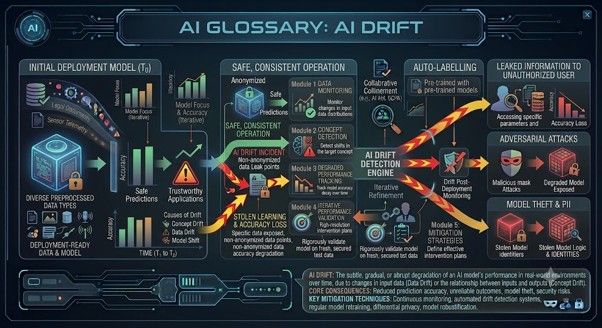
Drift
Drift tritt auf, wenn sich die Leistung eines KI-Modells im Laufe der Zeit verändert, weil sich die reale Welt verändert. Beispielsweise können sich das Kundenverhalten, Betrugsmethoden, medizinische Praktiken oder der Sprachgebrauch weiterentwickeln. Ein Modell, das im letzten Jahr noch gut funktioniert hat, kann heute weniger zuverlässig sein. Die Überwachung auf Drift ist bei jedem KI-System, das über einen längeren Zeitraum eingesetzt wird, unerlässlich.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
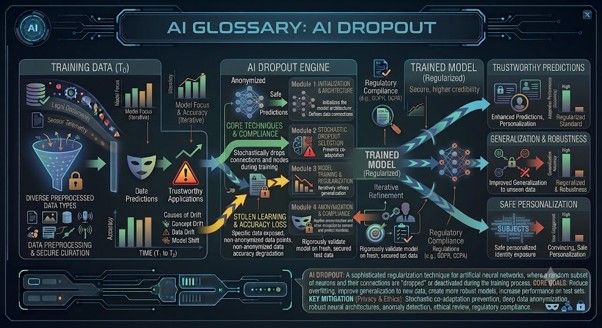
Dropout
Dropout ist eine Trainingstechnik, die in neuronalen Netzen eingesetzt wird, um Überanpassung zu reduzieren. Während des Trainings werden einige Verbindungen zufällig ignoriert, wodurch das Modell gezwungen wird, sich nicht zu stark auf einen einzelnen Pfad zu verlassen. Dies hilft dem Modell, neue Daten besser zu verallgemeinern. Es ist vergleichbar mit dem Training einer Mannschaft, bei dem darauf geachtet wird, dass die gesamte Gruppe gut abschneidet, anstatt sich auf einen einzelnen Starspieler zu verlassen.
 Bildnachweis: Zur Verfügung gestelltes Bild; Autor: Stephen Whitelaw;
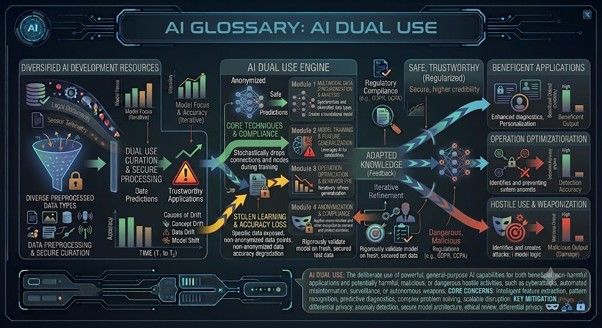
Dual-Use
„Dual Use“ bedeutet, dass eine Technologie sowohl für nützliche als auch für schädliche Zwecke eingesetzt werden kann. KI ist eine klassische Dual-Use-Technologie. Dasselbe Tool, das beim Verfassen von Lehrmaterial hilft, könnte auch zum Verfassen von Phishing-E-Mails beitragen. Dasselbe System zur Bilderzeugung, das Künstlern hilft, könnte gefälschte Beweise erstellen. Verantwortungsvolle KI erfordert, dass sowohl der Missbrauch als auch der beabsichtigte Einsatz berücksichtigt werden.
Legen Sie The Portugal News als Ihre bevorzugte Nachrichtenquelle bei Google fest
 Als bevorzugte Quelle bei Google hinzufügen


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media