


 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
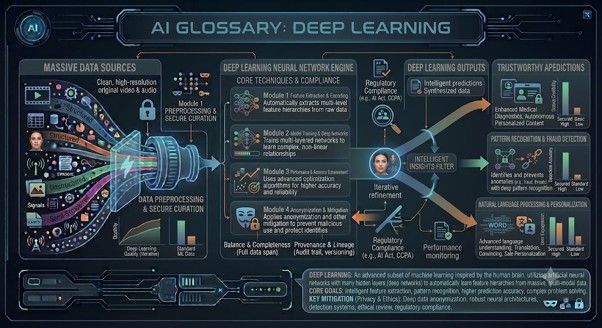
Uczenie głębokie
Głębokie uczenie się to rodzaj uczenia maszynowego opartego na wielowarstwowych sieciach neuronowych. Systemy te potrafią rozpoznawać złożone wzorce w obrazach, tekście, plikach audio i wideo. Głębokie uczenie się stanowi podstawę wielu współczesnych przełomowych osiągnięć w dziedzinie sztucznej inteligencji, w tym rozpoznawania mowy, generowania obrazów, tłumaczenia oraz rozbudowanych modeli językowych. Często wymaga ono dużych ilości danych i znacznej mocy obliczeniowej.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
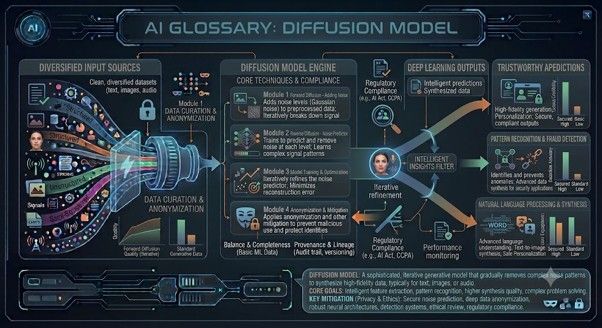
Model dyfuzyjny
Model dyfuzyjny to rodzaj generatywnej sztucznej inteligencji, często wykorzystywanej do tworzenia obrazów. Uczy się on generować dane, zaczynając od szumu i stopniowo udoskonalając go, aż do uzyskania spójnego obrazu lub wyniku. Wiele współczesnych narzędzi do generowania obrazów wykorzystuje techniki dyfuzyjne. Wynik może być bardzo realistyczny lub artystyczny, w zależności od podanego polecenia i modelu.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
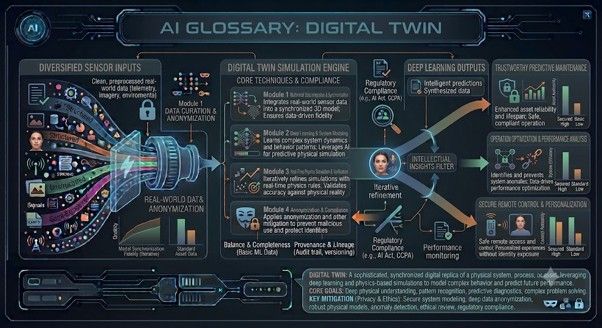
Cyfrowy bliźniak
Cyfrowy bliźniak to wirtualny model rzeczywistego obiektu, systemu lub procesu. Na przykład fabryka może posiadać cyfrowego bliźniaka, który symuluje działanie maszyn, zużycie energii i przebieg produkcji. Sztuczna inteligencja może zwiększyć możliwości cyfrowych bliźniaków poprzez przewidywanie problemów i testowanie zmian, zanim pojawią się one w rzeczywistym świecie. Cyfrowe bliźniaki są wykorzystywane w inżynierii, służbie zdrowia, transporcie oraz w inteligentnych miastach.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
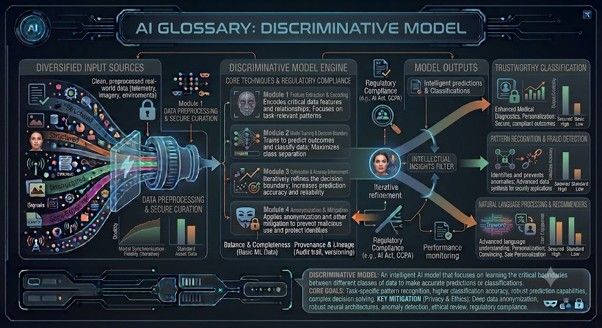
Model dyskryminacyjny
Model dyskryminacyjny uczy się rozróżniać kategorie. Na przykład może on zdecydować, czy wiadomość e-mail jest spamem, czy nie, albo czy obraz guza wskazuje na nowotwór łagodny, czy złośliwy. Modele dyskryminacyjne różnią się od modeli generatywnych, które tworzą nowe treści. Mówiąc prościej, modele dyskryminacyjne klasyfikują, a modele generatywne tworzą.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
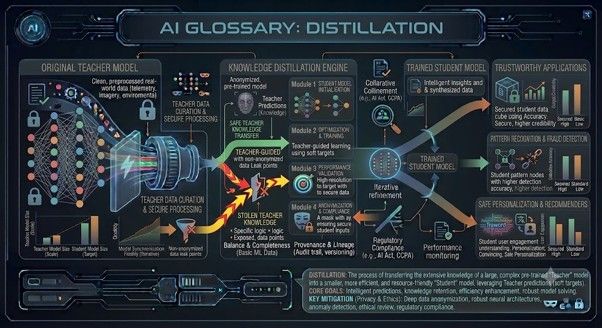
Destylacja
Destylacja AI polega na szkoleniu małego, szybkiego modelu AI, aby skopiował wiedzę i zachowanie dużego, inteligentnego modelu AI. Można to porównać do sytuacji, w której mistrz kuchni (duży model) uczy praktykanta (mały model) wszystkich swoich sekretnych przepisów i technik, dzięki czemu praktykant może przygotowywać potrawy tej samej jakości, tylko znacznie szybciej i przy użyciu mniejszej liczby narzędzi kuchennych.Dlaczego się z tego korzysta? Oszczędza miejsce: zmniejsza ogromne systemy sztucznej inteligencji, dzięki czemu mieszczą się one na smartfonie lub laptopie. Oszczędza pieniądze: uruchomienie mniejszego modelu wymaga znacznie mniejszej mocy obliczeniowej. Oszczędza czas: mniejszy model udziela odpowiedzi znacznie szybciej niż ten gigantyczny.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
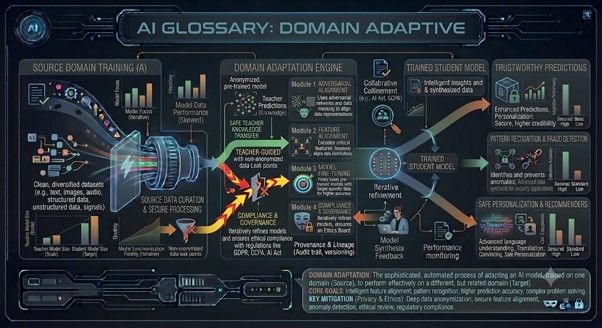
Adaptacja domenowa
Adaptacja domenowa to proces dostosowywania modelu sztucznej inteligencji tak, by dobrze funkcjonował w nowym, ale powiązanym kontekście. Na przykład model wytrenowany na danych szpitalnych z jednego kraju może nie działać równie dobrze w innym kraju ze względu na różnice w sprzęcie, pacjentach lub procedurach. Adaptacja domenowa pomaga modelom przenosić wiedzę, dostosowując się jednocześnie do lokalnych warunków.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
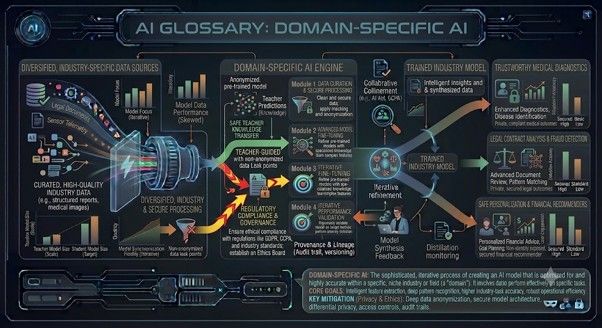
Sztuczna inteligencja dziedzinowa
Sztuczna inteligencja dziedzinowa to sztuczna inteligencja zaprojektowana dla konkretnej dziedziny, takiej jak opieka zdrowotna, prawo, finanse, edukacja, rolnictwo czy produkcja. Systemy te mogą być dokładniejsze i bardziej użyteczne niż narzędzia ogólnego przeznaczenia, ponieważ opierają się na specjalistycznej wiedzy i procesach roboczych. Jednak sztuczna inteligencja dziedzinowa wymaga nadzoru ekspertów, ponieważ popełnione błędy mogą mieć poważne konsekwencje.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
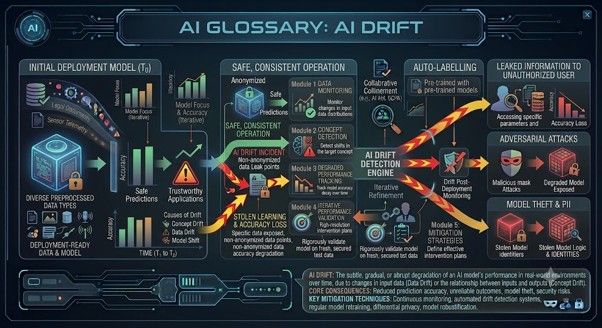
Dryf
Odchylenie występuje, gdy wydajność modelu sztucznej inteligencji zmienia się w miarę upływu czasu w wyniku zmian zachodzących w świecie rzeczywistym. Na przykład mogą ewoluować zachowania klientów, taktyki oszustów, praktyki medyczne lub sposób użycia języka. Model, który w zeszłym roku działał dobrze, może dziś stać się mniej niezawodny. Monitorowanie odchyleń jest niezbędne w każdym systemie sztucznej inteligencji używanym przez dłuższy czas.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
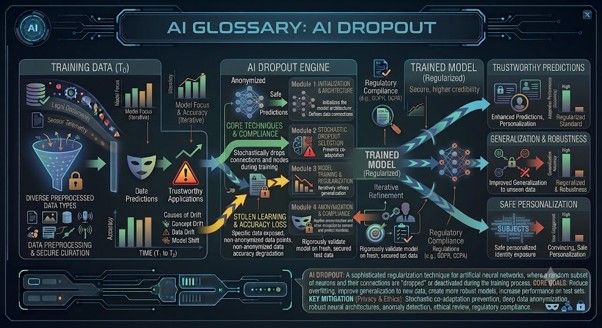
Dropout
Dropout to technika uczenia stosowana w sieciach neuronowych w celu ograniczenia nadmiernego dopasowania. Podczas uczenia niektóre połączenia są losowo pomijane, co zmusza model do unikania nadmiernego polegania na jednej ścieżce. Pomaga to modelowi lepiej uogólniać wyniki na nowych danych. Przypomina to szkolenie drużyny tak, aby cała grupa osiągała dobre wyniki, zamiast polegać na jednym gwiazdorze.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
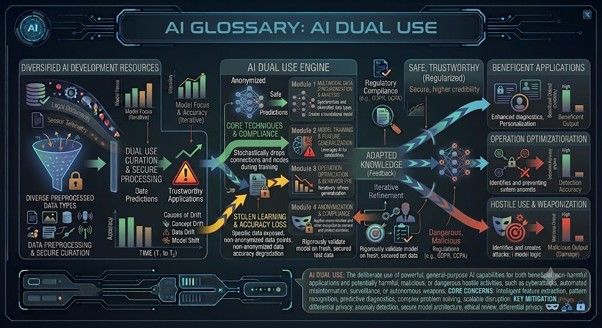
Podwójne zastosowanie
Podwójne zastosowanie oznacza, że technologia może być wykorzystywana zarówno w celach pożytecznych, jak i szkodliwych. Sztuczna inteligencja jest klasycznym przykładem technologii o podwójnym zastosowaniu. To samo narzędzie, które pomaga w tworzeniu materiałów edukacyjnych, może również posłużyć do pisania wiadomości phishingowych. Ten sam system generowania obrazów, który pomaga artystom, może służyć do tworzenia fałszywych dowodów. Odpowiedzialne wykorzystanie sztucznej inteligencji wymaga uwzględnienia zarówno zamierzonego zastosowania, jak i możliwości nadużycia.
Ustaw The Portugal News jako preferowane źródło wiadomości w Google
 Dodaj jako preferowane źródło w Google


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media