


 Crédits : image fournie ; Auteur : Stephen Whitelaw ;
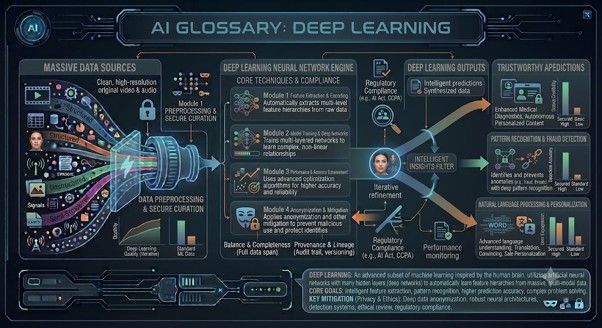
Apprentissage profond
L'apprentissage profond est un type d'apprentissage automatique basé sur des réseaux neuronaux à plusieurs couches. Ces systèmes sont capables d'apprendre des modèles complexes à partir d'images, de textes, de fichiers audio et de vidéos. L'apprentissage profond est à l'origine de nombreuses avancées modernes en matière d'IA, notamment la reconnaissance vocale, la génération d'images, la traduction et les grands modèles linguistiques. Il nécessite souvent de grandes quantités de données et une puissance de calcul importante.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
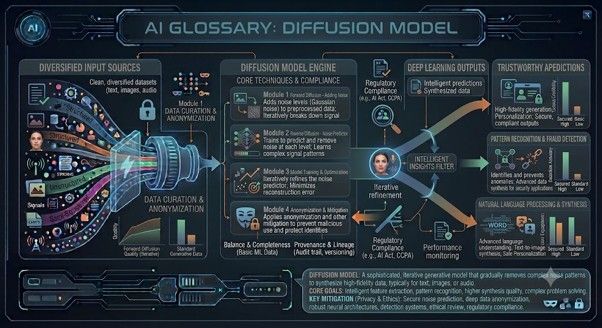
Modèle de diffusion
Un modèle de diffusion est un type d’IA générative souvent utilisé pour créer des images. Il apprend à générer des données en partant d’un bruit qu’il affine progressivement pour obtenir une image ou un résultat cohérent. De nombreux outils modernes de génération d’images utilisent des techniques de diffusion. Le résultat peut être très réaliste ou artistique, selon la consigne et le modèle.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
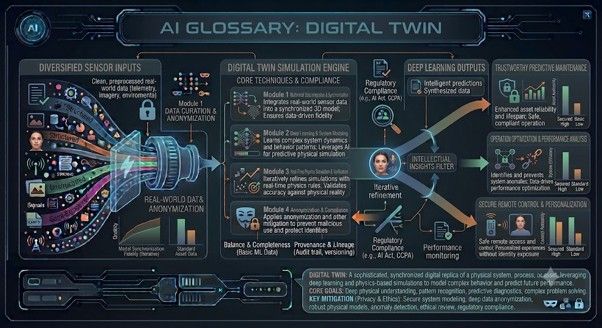
Jumeau numérique
Un jumeau numérique est un modèle virtuel d’un objet, d’un système ou d’un processus du monde réel. Par exemple, une usine peut disposer d’un jumeau numérique qui simule les machines, la consommation d’énergie et le flux de production. L’IA peut rendre les jumeaux numériques plus performants en anticipant les problèmes et en testant les changements avant qu’ils ne se produisent dans le monde réel. Les jumeaux numériques sont utilisés dans l’ingénierie, la santé, les transports et les villes intelligentes.
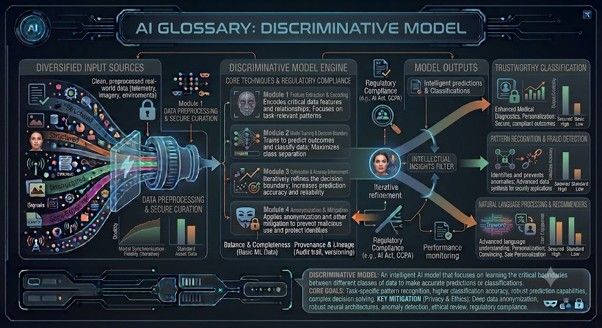 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Modèle discriminatif
Un modèle discriminatif apprend à distinguer différentes catégories. Par exemple, il peut déterminer si un e-mail est un spam ou non, ou si l’image d’une tumeur semble bénigne ou maligne. Les modèles discriminatifs se distinguent des modèles génératifs, qui créent du nouveau contenu. En termes simples, les modèles discriminatifs classifient ; les modèles génératifs produisent.
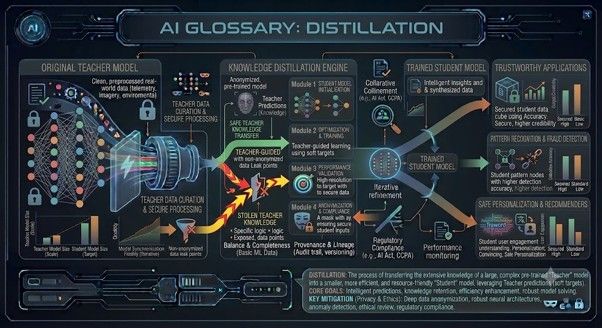 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Distillation
La distillation en IA consiste à entraîner un petit modèle d’IA rapide afin qu’il reproduise les connaissances et le comportement d’un grand modèle d’IA intelligent. Imaginez un chef cuisinier (le grand modèle) enseignant à un apprenti (le petit modèle) toutes ses recettes et techniques secrètes afin que ce dernier puisse cuisiner des plats de même qualité, mais beaucoup plus rapidement et avec moins d’ustensiles de cuisine.Pourquoi y a-t-on recours ? Gain de place : cela permet de réduire la taille des systèmes d’IA massifs afin qu’ils puissent tenir sur un smartphone ou un ordinateur portable. Économie d’argent : l’exécution du petit modèle nécessite nettement moins de puissance de calcul. Gain de temps : le petit modèle fournit des réponses bien plus rapidement que le modèle géant.
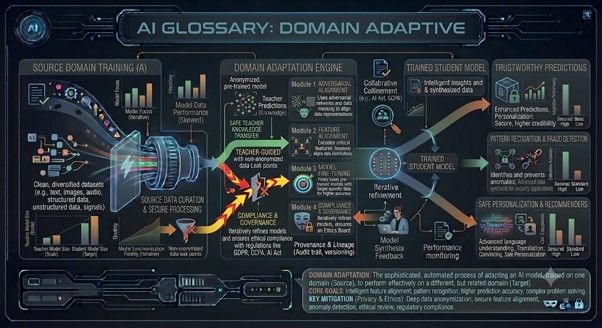 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Adaptation de domaine
L’adaptation de domaine est le processus qui consiste à faire fonctionner correctement un modèle d’IA dans un nouveau contexte, mais apparenté au précédent. Par exemple, un modèle entraîné sur des données hospitalières d’un pays donné peut ne pas fonctionner aussi bien dans un autre pays en raison de différences au niveau des équipements, des patients ou des procédures. L’adaptation de domaine aide les modèles à transférer leurs connaissances tout en s’adaptant aux conditions locales.
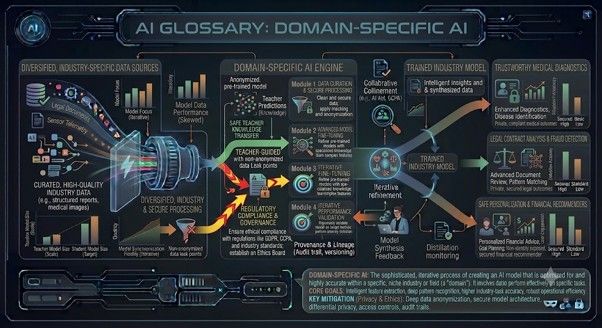 Crédits : image fournie ; auteur : Stephen Whitelaw ;
IA spécifique à un domaine
L’IA spécifique à un domaine est une IA conçue pour un secteur particulier, tel que la santé, le droit, la finance, l’éducation, l’agriculture ou l’industrie. Ces systèmes peuvent s’avérer plus précis et plus utiles que les outils généraux, car ils s’appuient sur des connaissances et des processus de travail spécialisés. Cependant, l’IA spécifique à un domaine nécessite la supervision d’experts, car les erreurs peuvent avoir de graves conséquences.
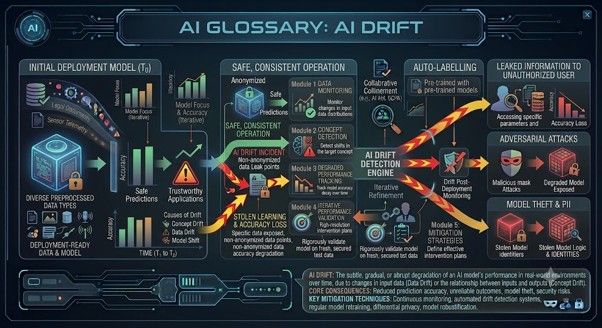 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Dérive
La dérive se produit lorsque les performances d’un modèle d’IA évoluent au fil du temps en raison des changements du monde réel. Par exemple, le comportement des clients, les tactiques de fraude, les pratiques médicales ou l’usage de la langue peuvent évoluer. Un modèle qui fonctionnait bien l’année dernière peut devenir moins fiable aujourd’hui. La surveillance de la dérive est essentielle dans tout système d’IA utilisé sur le long terme.
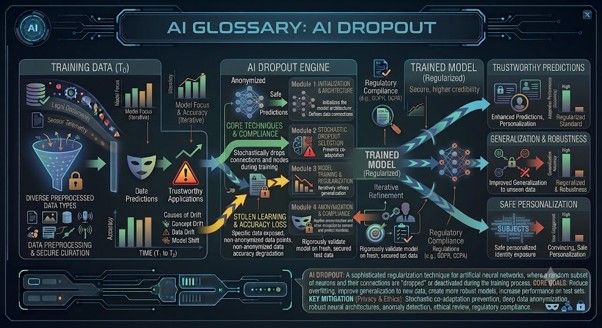 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Dropout
Le « dropout » est une technique d’entraînement utilisée dans les réseaux neuronaux pour réduire le surapprentissage. Pendant l’entraînement, certaines connexions sont ignorées de manière aléatoire, ce qui oblige le modèle à ne pas trop s’appuyer sur un seul chemin. Cela aide le modèle à mieux généraliser à de nouvelles données. Cela revient à entraîner une équipe de manière à ce que l’ensemble du groupe soit performant, plutôt que de dépendre d’un seul joueur vedette.
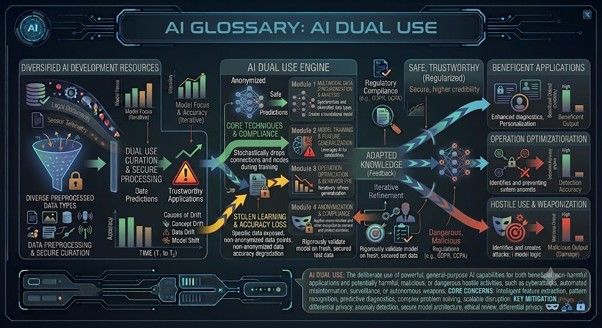 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Double usage
Le terme « double usage » désigne une technologie pouvant être utilisée à des fins à la fois utiles et néfastes. L’IA est une technologie classique à double usage. Le même outil qui aide à rédiger du contenu pédagogique pourrait également servir à rédiger des e-mails de hameçonnage. Le même système de génération d’images qui aide les artistes pourrait créer de fausses preuves. Une IA responsable nécessite de réfléchir aussi bien aux utilisations abusives qu’aux utilisations prévues.
Définissez The Portugal News comme votre source d'actualités préférée sur Google
 Ajouter comme source préférée sur Google


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media