


 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Dall-E 3
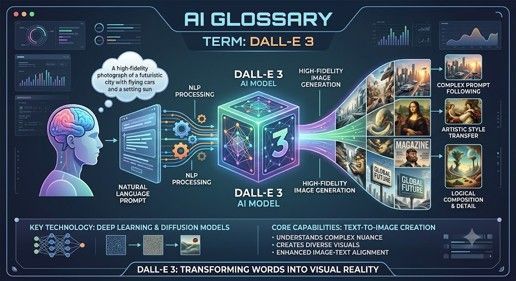
DALL-E 3 était un modèle de génération d'images à partir de texte basé sur l'apprentissage profond, développé par OpenAI, qui générait des images détaillées et en haute résolution à partir de descriptions en langage naturel (invites). Lancé fin 2023, il représentait une avancée majeure par rapport aux modèles visuels génératifs précédents en améliorant considérablement la fidélité aux invites, la qualité des images et le rendu des détails complexes.
Principales caractéristiques et capacités
· Compréhension native du langage : conçu dès le départ pour saisir les nuances subtiles, les relations spatiales et le contexte détaillé des consignes des utilisateurs, sans nécessiter de « conception complexe des consignes ».
· Rendu de texte dans l’image : capable de générer du texte clair et lisible intégré directement dans les images (par exemple, des panneaux, des étiquettes, des logos).
· Intégration à ChatGPT : intégré nativement à ChatGPT Plus/Enterprise, ce qui permet aux utilisateurs de réfléchir, d’affiner et d’itérer sur des consignes visuelles de manière conversationnelle.
· Sécurité et provenance : intègre des garde-fous de sécurité pour empêcher la génération de contenu explicite, de caricatures de personnalités publiques ou d’imitations du style d’artistes vivants, et utilise les métadonnées de provenance C2PA pour identifier les images générées par l’IA.
N.B. : DALL-E 3 n’est pratiquement plus utilisé en standard, car OpenAI et Microsoft l’ont officiellement retiré et déprécié. Il a été remplacé par des systèmes multimodaux natifs plus récents
 Crédits : Image fournie ; Auteur : Stephen Whitelaw ;
Données
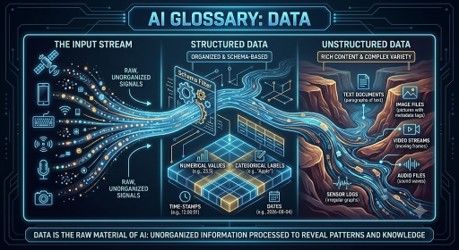
Les données constituent la matière première utilisée par les systèmes d’IA. Elles peuvent inclure du texte, des images, des fichiers audio, des vidéos, des chiffres, des transactions, des relevés de capteurs ou des dossiers médicaux. Les systèmes d’IA apprennent des modèles à partir des données. La qualité, la pertinence et l’équité des données sont cruciales. Des données de mauvaise qualité peuvent conduire à une IA de mauvaise qualité, quelle que soit l’apparente sophistication du modèle.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Augmentation des données
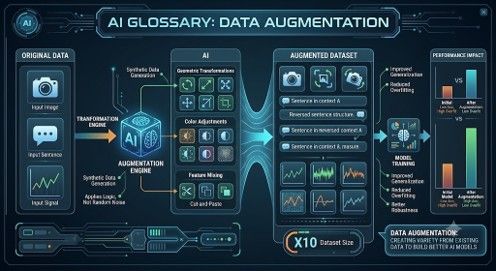
L'augmentation des données consiste à créer des versions modifiées d'exemples d'entraînement existants afin d'améliorer un modèle. Pour les images, cela peut impliquer de les faire pivoter, de les recadrer ou de modifier leur luminosité. Pour le texte, cela peut consister à paraphraser. L'objectif est de rendre le modèle plus robuste en l'exposant à des variations. L'augmentation des données est particulièrement utile lorsque l'ensemble de données d'origine est limité.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
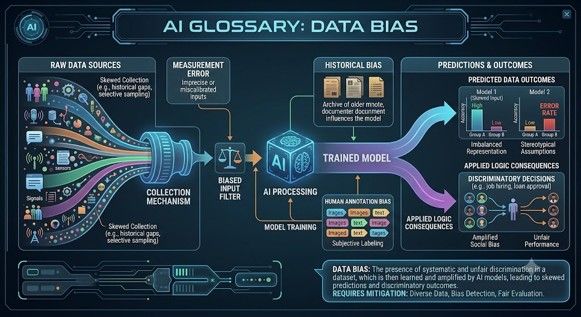
Biais des données
On parle de biais des données lorsque les données utilisées pour entraîner ou tester un système d’IA ne sont pas représentatives, sont incomplètes ou biaisées. Par exemple, un système de reconnaissance faciale entraîné principalement sur un groupe démographique donné peut présenter des performances moins bonnes avec d’autres groupes. Le biais des données est l’une des principales causes d’un comportement inéquitable ou peu fiable de l’IA.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
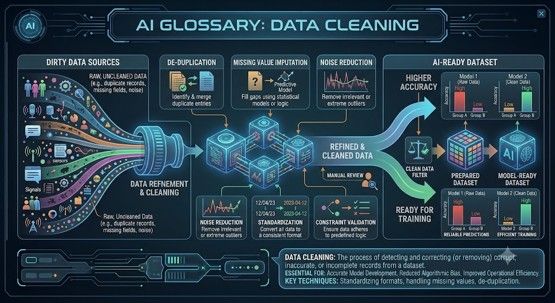
Nettoyage des données
Le nettoyage des données consiste à corriger, supprimer ou organiser des données désordonnées avant leur utilisation. Les données issues du monde réel contiennent souvent des doublons, des valeurs manquantes, des fautes d’orthographe, des entrées obsolètes ou des formats incohérents. Les systèmes d’IA dépendent fortement de données propres. Dans de nombreux projets, le nettoyage des données prend plus de temps que la construction du modèle.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
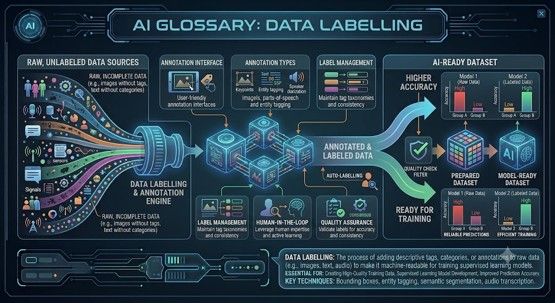
Étiquetage des données
L'étiquetage des données consiste à ajouter des balises significatives aux données afin qu'un système d'IA puisse en tirer des enseignements. Par exemple, étiqueter des e-mails comme « spam » ou « pas de spam » permet d'entraîner un filtre anti-spam. L'étiquetage d'images médicales peut aider à entraîner des outils de diagnostic. Un bon étiquetage nécessite des règles claires et un contrôle qualité, en particulier lorsque l'avis d'un expert est requis.
 Crédits : Image fournie ; Auteur : Stephen Whitelaw ;
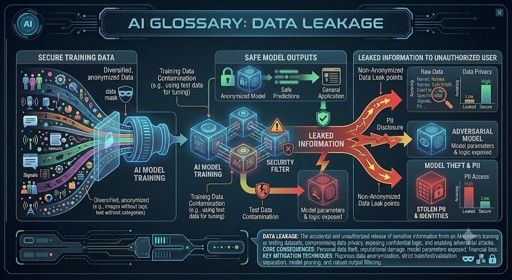
Fuite de données
Une fuite de données se produit lorsque des informations issues des données de test influencent accidentellement le processus d’entraînement. Cela donne au modèle une performance apparente supérieure à sa performance réelle. Par exemple, si un modèle est entraîné à l’aide d’informations qui ne seraient pas disponibles dans la réalité, l’estimation de ses performances devient peu fiable. La fuite de données est une erreur courante mais grave dans les projets d’apprentissage automatique.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Exploration de données
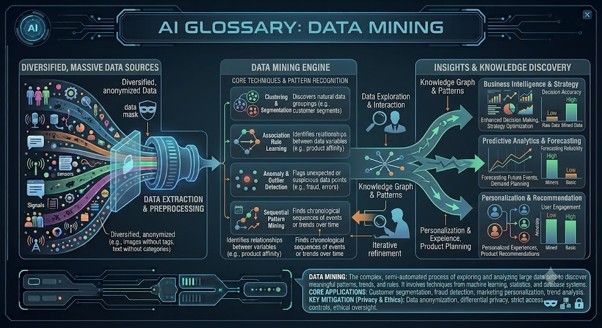
L'exploration de données consiste à identifier des tendances, des relations ou des informations utiles au sein de grands ensembles de données. Cette pratique existait avant l'IA moderne, mais elle recoupe l'apprentissage automatique. Les entreprises ont recours à l'exploration de données pour comprendre leurs clients, détecter les fraudes, prévoir la demande et améliorer leurs opérations. Le risque réside dans le fait que ces tendances puissent être mal interprétées ou utilisées sans garanties adéquates en matière de protection de la vie privée.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Confidentialité des données
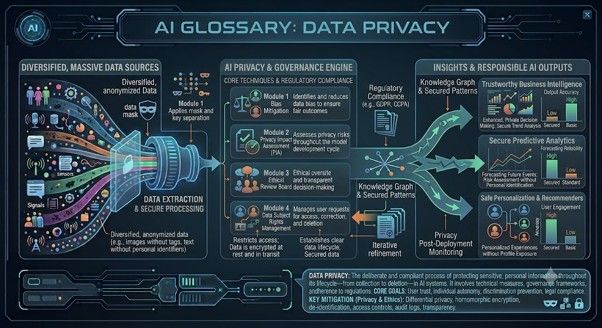
La protection des données concerne la manière dont les informations personnelles sont collectées, utilisées, stockées et partagées. L’IA soulève de nouvelles préoccupations en matière de confidentialité, car les modèles peuvent être entraînés à partir de vastes ensembles de données, comprenant notamment des informations sensibles. Les organisations utilisant l’IA doivent prendre en compte le consentement, la sécurité, l’anonymisation, la conservation des données et la conformité légale. La protection des données n’est pas seulement une question technique ; c’est une question de confiance.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Ensemble de données
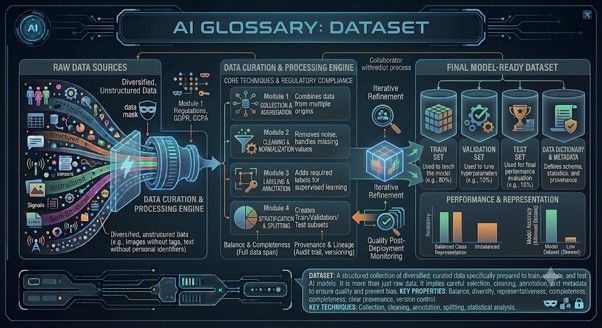
Un ensemble de données est un recueil structuré de données utilisé pour l'entraînement, le test ou l'analyse d'un système d'IA. Un ensemble de données peut contenir des dossiers clients, des images médicales, des avis sur des produits, des transactions financières ou des photographies annotées. La taille, la qualité et la représentativité de l'ensemble de données influencent fortement les performances du modèle.
 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Arbre de décision
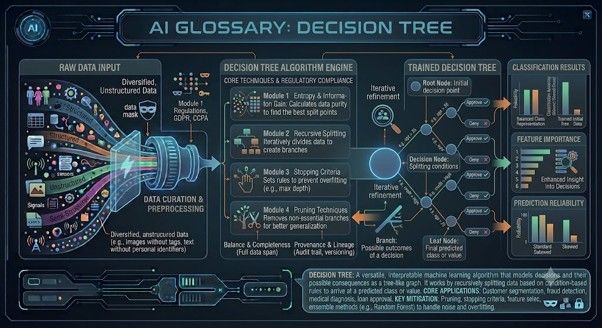
Un arbre de décision est un modèle d’apprentissage automatique qui prend des décisions à travers une séquence de questions. Par exemple : le client a-t-il plus de 18 ans ? Le paiement a-t-il déjà échoué ? La transaction est-elle d’un montant inhabituellement élevé ? Les arbres de décision sont très utilisés car ils sont plus faciles à comprendre que de nombreux modèles de type « boîte noire ». Ils sont souvent utilisés pour la notation des risques, la classification et les règles métier.
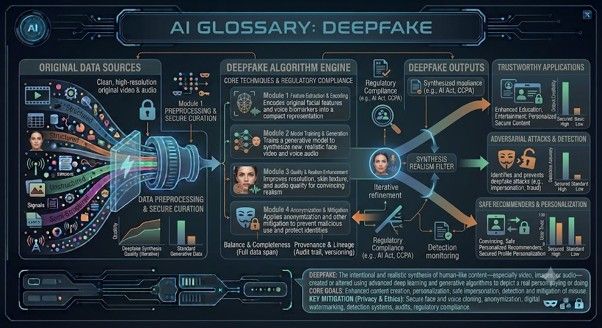 Crédits : image fournie ; auteur : Stephen Whitelaw ;
Deepfake
Un deepfake est un contenu multimédia généré ou manipulé par l’IA qui donne l’impression qu’une personne dit ou fait quelque chose qu’elle n’a ni dit ni fait. Les deepfakes peuvent être utilisés à des fins de divertissement, mais aussi pour commettre des fraudes, du harcèlement, de la désinformation et de la manipulation politique. À mesure que les deepfakes gagnent en réalisme, l’éducation aux médias et la vérification des informations deviennent de plus en plus importantes.
Définissez The Portugal News comme votre source d'actualités préférée sur Google
 Ajouter comme source préférée sur Google





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media