


 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
Dall-E 3
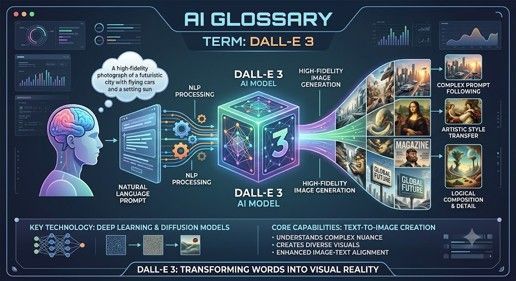
DALL-E 3 era un modello di deep learning "da testo a immagine" sviluppato da OpenAI in grado di generare immagini dettagliate e ad alta risoluzione a partire da descrizioni in linguaggio naturale (prompt). Rilasciato alla fine del 2023, rappresentava un importante passo avanti rispetto ai precedenti modelli visivi generativi, grazie a un significativo miglioramento nella fedeltà ai prompt, nella qualità delle immagini e nella resa dei dettagli complessi.
Caratteristiche e funzionalità principali
· Comprensione nativa del linguaggio: progettato per comprendere in modo nativo le sfumature sottili, le relazioni spaziali e il contesto dettagliato all’interno dei prompt degli utenti senza richiedere una complessa “ingegneria dei prompt”.
· Rendering di testo all’interno delle immagini: in grado di generare testo chiaro e leggibile incorporato direttamente nelle immagini (ad es. cartelli, etichette, loghi).
· Integrazione con ChatGPT: integrato nativamente in ChatGPT Plus/Enterprise, consentendo agli utenti di elaborare idee, perfezionare e iterare i prompt visivi in modo conversazionale.
· Sicurezza e provenienza: incorpora misure di sicurezza integrate per impedire la generazione di contenuti espliciti, caricature di personaggi pubblici o imitazioni dello stile di artisti viventi, e utilizza metadati di provenienza C2PA per identificare le immagini generate dall’IA.
N.B. DALL-E 3 non è più utilizzato come standard, poiché OpenAI e Microsoft lo hanno ufficialmente ritirato e deprecato. È stato sostituito da sistemi multimodali nativi più recenti
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
Dati
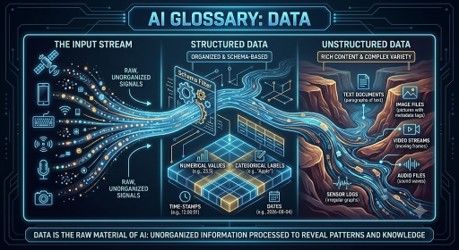
I dati sono la materia prima utilizzata dai sistemi di IA. Possono includere testo, immagini, audio, video, numeri, transazioni, letture dei sensori o cartelle cliniche. I sistemi di IA apprendono modelli dai dati. La qualità, la pertinenza e l’equità dei dati sono fondamentali. Dati di scarsa qualità possono portare a un’IA inadeguata, indipendentemente da quanto avanzato possa sembrare il modello.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
Aumento dei dati
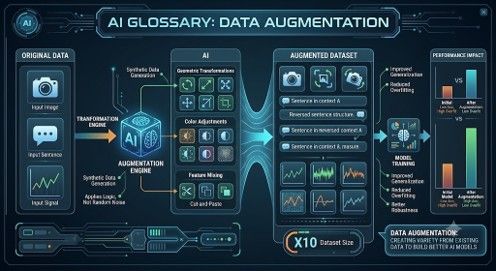
L’aumentazione dei dati consiste nel creare versioni modificate di esempi di addestramento esistenti per migliorare un modello. Per le immagini, ciò può comportare la rotazione, il ritaglio o la modifica della luminosità. Per il testo, può comportare la parafrasi. L’obiettivo è rendere il modello più robusto esponendolo a variazioni. L’aumentazione dei dati è particolarmente utile quando il set di dati originale è limitato.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
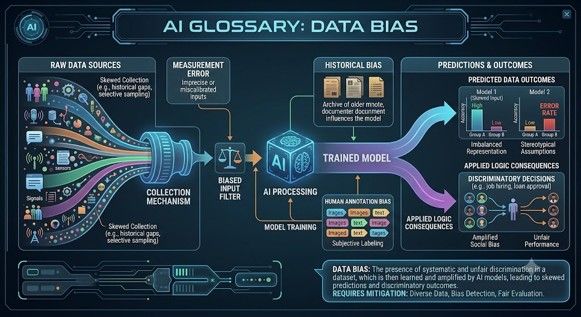
Distorsione dei dati
Il bias dei dati si verifica quando i dati utilizzati per addestrare o testare un sistema di IA non sono rappresentativi, sono incompleti o distorti. Ad esempio, un sistema di riconoscimento facciale addestrato prevalentemente su un gruppo demografico potrebbe ottenere prestazioni inferiori con altri gruppi. Il bias dei dati è una delle cause principali di comportamenti ingiusti o inaffidabili da parte dell’IA.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
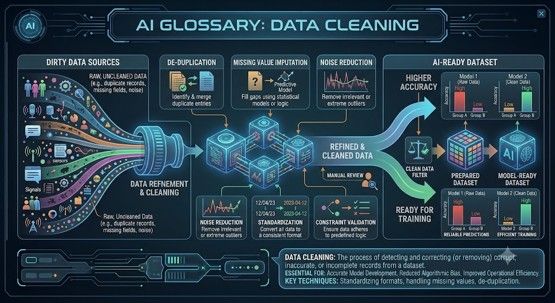
Pulizia dei dati
La pulizia dei dati è il processo di correzione, rimozione o organizzazione dei dati disordinati prima del loro utilizzo. I dati del mondo reale contengono spesso duplicati, valori mancanti, errori ortografici, voci obsolete o formati incoerenti. I sistemi di IA dipendono fortemente da dati puliti. In molti progetti, la pulizia dei dati richiede più tempo rispetto alla costruzione del modello.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
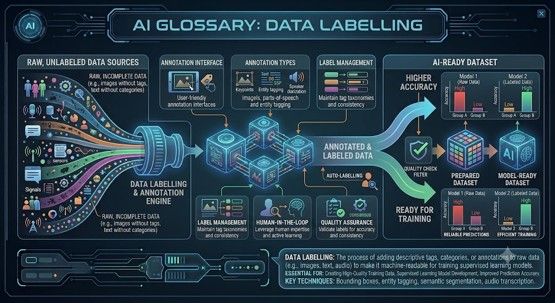
Etichettatura dei dati
L’etichettatura dei dati è il processo che consiste nell’aggiungere tag significativi ai dati in modo che un sistema di IA possa imparare da essi. Ad esempio, etichettare le e-mail come “spam” o “non spam” aiuta ad addestrare un filtro antispam. L’etichettatura delle immagini mediche può aiutare ad addestrare strumenti diagnostici. Una buona etichettatura richiede regole chiare e un controllo di qualità, specialmente quando è necessario il giudizio di un esperto.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
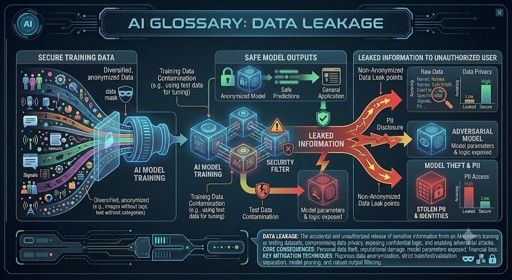
Fuga di dati
La fuga di dati si verifica quando le informazioni provenienti dai dati di test influenzano accidentalmente il processo di addestramento. Ciò fa apparire il modello migliore di quanto non sia in realtà. Ad esempio, se un modello viene addestrato utilizzando informazioni che non sarebbero disponibili nella vita reale, la stima delle sue prestazioni diventa inaffidabile. La fuga di dati è un errore comune ma grave nei progetti di apprendimento automatico.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
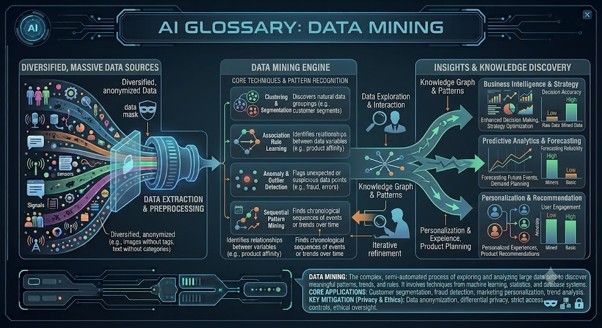
Data mining
Il data mining è il processo di individuazione di modelli, relazioni o informazioni utili all’interno di grandi set di dati. Esisteva già prima dell’intelligenza artificiale moderna, ma si sovrappone all’apprendimento automatico. Le aziende utilizzano il data mining per comprendere i clienti, individuare le frodi, prevedere la domanda e migliorare le operazioni. Il rischio è che i modelli possano essere interpretati in modo errato o utilizzati senza adeguate garanzie di privacy.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
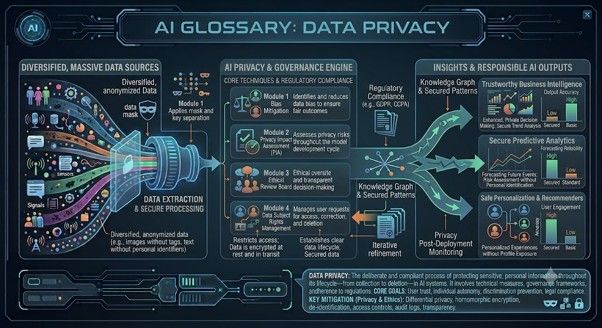
Privacy dei dati
La privacy dei dati riguarda il modo in cui le informazioni personali vengono raccolte, utilizzate, archiviate e condivise. L’intelligenza artificiale solleva nuove preoccupazioni in materia di privacy poiché i modelli possono essere addestrati su grandi insiemi di dati, comprese informazioni sensibili. Le organizzazioni che utilizzano l’intelligenza artificiale devono tenere conto del consenso, della sicurezza, dell’anonimizzazione, della conservazione dei dati e della conformità legale. La privacy non è solo una questione tecnica; è una questione di fiducia.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
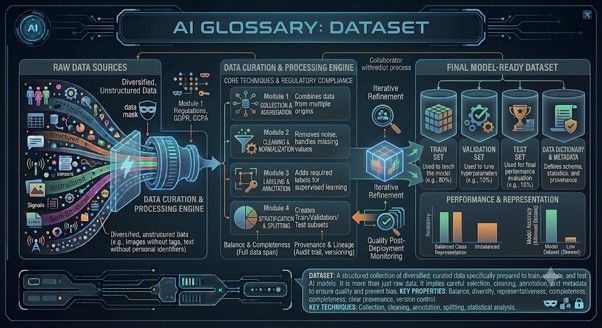
Set di dati
Un set di dati è una raccolta strutturata di dati utilizzata per l’addestramento, il test o l’analisi di un sistema di IA. Un set di dati può contenere record dei clienti, immagini mediche, recensioni di prodotti, transazioni finanziarie o fotografie etichettate. Le dimensioni, la qualità e la rappresentatività del set di dati influenzano fortemente le prestazioni del modello.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
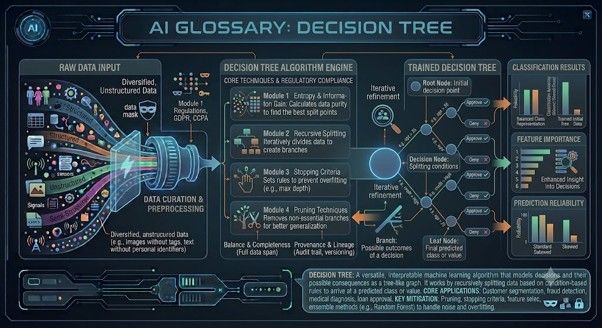
Albero decisionale
Un albero decisionale è un modello di apprendimento automatico che prende decisioni attraverso una sequenza di domande. Ad esempio: il cliente ha più di 18 anni? Il pagamento è già fallito in precedenza? La transazione è di importo insolitamente elevato? Gli alberi decisionali sono molto diffusi perché sono più facili da comprendere rispetto a molti modelli di tipo “scatola nera”. Sono spesso utilizzati nella valutazione del rischio, nella classificazione e nelle regole aziendali.
 Crediti: Immagine fornita; Autore: Stephen Whitelaw;
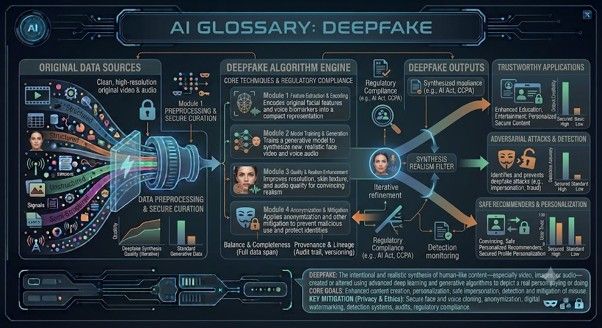
Deepfake
Un deepfake è un contenuto multimediale generato o manipolato dall’intelligenza artificiale che fa sembrare che qualcuno dica o faccia qualcosa che in realtà non ha detto o fatto. I deepfake possono essere utilizzati a scopo di intrattenimento, ma anche per frodi, molestie, disinformazione e manipolazione politica. Man mano che i deepfake diventano più realistici, l’alfabetizzazione mediatica e la verifica dei contenuti assumono un’importanza sempre maggiore.
Imposta The Portugal News come fonte preferita per le notizie su Google
 Aggiungi come fonte preferita su Google





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media