


 Bronvermelding: Afbeelding ter beschikking gesteld; Auteur: Stephen Whitelaw;
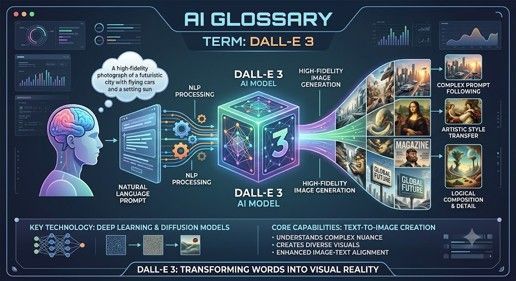
Dall-E 3
DALL-E 3 was een door OpenAI ontwikkeld deep learning-model voor tekst-naar-beeld dat gedetailleerde afbeeldingen met hoge resolutie genereerde op basis van beschrijvingen in natuurlijke taal (prompts). Het model werd eind 2023 uitgebracht en betekende een belangrijke verbetering ten opzichte van eerdere generatieve visuele modellen door de nauwkeurigheid bij het volgen van prompts, de beeldkwaliteit en de weergave van complexe details aanzienlijk te verbeteren.
Belangrijkste kenmerken en mogelijkheden
· Inhoudelijk begrip van de taal: Van meet af aan ontworpen om subtiele nuances, ruimtelijke relaties en gedetailleerde context binnen gebruikersprompts te begrijpen, zonder dat er complexe „prompt engineering“ nodig is.
· Weergave van tekst in afbeeldingen: Kan heldere, leesbare tekst genereren die direct in afbeeldingen is ingebed (bijv. borden, labels, logo’s).
· ChatGPT-integratie: Standaard geïntegreerd in ChatGPT Plus/Enterprise, waardoor gebruikers op conversatieachtige wijze kunnen brainstormen, verfijnen en itereren op visuele prompts.
· Veiligheid en herkomst: Bevat ingebouwde veiligheidsmaatregelen om het genereren van expliciete inhoud, karikaturen van publieke figuren of stijlimitatie van levende kunstenaars te voorkomen, en maakt gebruik van C2PA-herkomstmetadata om door AI gegenereerde afbeeldingen te identificeren.
N.B. DALL-E 3 wordt grotendeels niet meer standaard gebruikt, omdat OpenAI en Microsoft het officieel hebben stopgezet en afgeschreven. Het is vervangen door nieuwere, native multimodale systemen
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
Gegevens
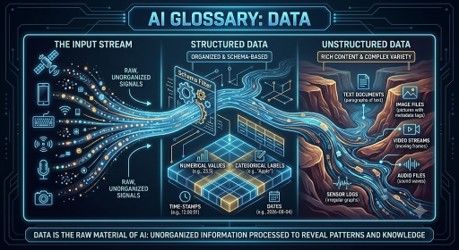
Gegevens vormen de grondstof voor AI-systemen. Het kan gaan om tekst, afbeeldingen, audio, video, getallen, transacties, sensorwaarden of medische dossiers. AI-systemen leren patronen uit gegevens. De kwaliteit, relevantie en eerlijkheid van de gegevens zijn cruciaal. Slechte gegevens kunnen leiden tot slechte AI, hoe geavanceerd het model ook lijkt.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
Data-augmentatie
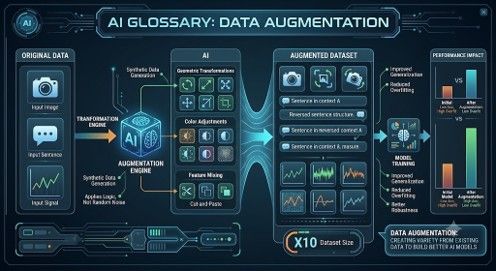
Data-augmentatie houdt in dat er aangepaste versies van bestaande trainingsvoorbeelden worden gemaakt om een model te verbeteren. Bij afbeeldingen kan dit bijvoorbeeld het draaien, bijsnijden of aanpassen van de helderheid inhouden. Bij tekst kan het gaan om parafraseren. Het doel is om het model robuuster te maken door het bloot te stellen aan variatie. Data-augmentatie is vooral nuttig wanneer de oorspronkelijke dataset beperkt is.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
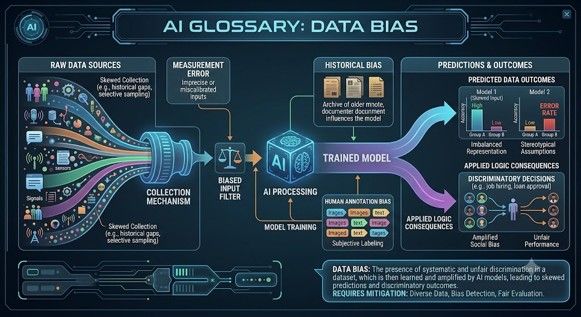
Databias
Er is sprake van gegevensvertekening wanneer de gegevens die worden gebruikt om een AI-systeem te trainen of te testen, niet representatief, onvolledig of scheef zijn. Een gezichtsherkenningssysteem dat bijvoorbeeld voornamelijk is getraind op één demografische groep, kan bij andere groepen slechter presteren. Gegevensvertekening is een van de belangrijkste oorzaken van oneerlijk of onbetrouwbaar AI-gedrag.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
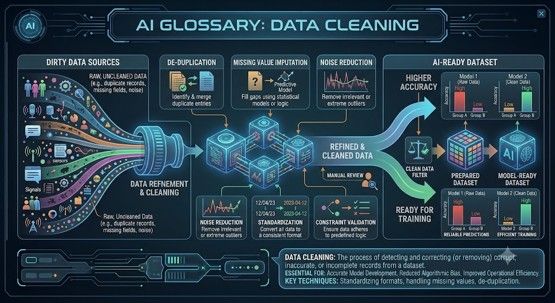
Gegevensopschoning
Datareiniging is het proces waarbij rommelige gegevens worden gecorrigeerd, verwijderd of geordend voordat ze worden gebruikt. Gegevens uit de praktijk bevatten vaak duplicaten, ontbrekende waarden, spelfouten, verouderde gegevens of inconsistente formaten. AI-systemen zijn sterk afhankelijk van schone gegevens. Bij veel projecten kost het opschonen van gegevens meer tijd dan het bouwen van het model.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
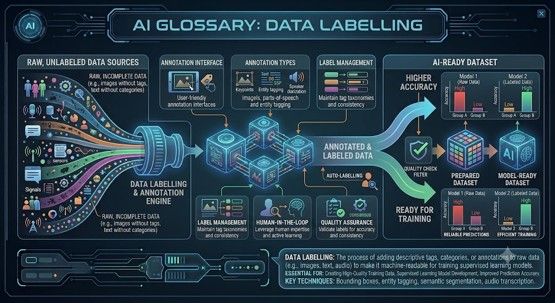
Gegevenslabeling
Het labelen van gegevens is het proces waarbij betekenisvolle labels aan gegevens worden toegevoegd, zodat een AI-systeem ervan kan leren. Het labelen van e-mails als ‘spam’ of ‘geen spam’ helpt bijvoorbeeld bij het trainen van een spamfilter. Het labelen van medische beelden kan helpen bij het trainen van diagnostische hulpmiddelen. Goed labelen vereist duidelijke regels en kwaliteitscontrole, vooral wanneer het oordeel van een expert nodig is.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
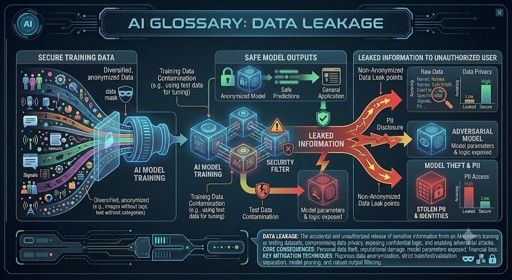
Gegevenslek
Er is sprake van datalekken wanneer informatie uit de testgegevens per ongeluk het trainingsproces beïnvloedt. Hierdoor lijkt het model beter dan het in werkelijkheid is. Als een model bijvoorbeeld wordt getraind met informatie die in de praktijk niet beschikbaar zou zijn, wordt de prestatieschatting onbetrouwbaar. Datalekken zijn een veelvoorkomende maar ernstige fout in machine learning-projecten.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
Datamining
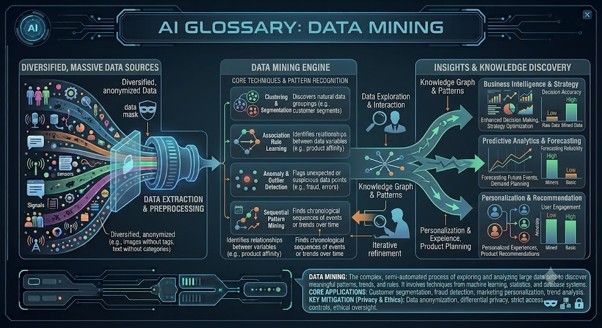
Datamining is het proces waarbij patronen, verbanden of nuttige informatie in grote datasets worden ontdekt. Het bestond al vóór de moderne AI, maar raakt aan machine learning. Bedrijven gebruiken datamining om klanten te begrijpen, fraude op te sporen, de vraag te voorspellen en hun bedrijfsvoering te verbeteren. Het risico is dat patronen verkeerd worden geïnterpreteerd of worden gebruikt zonder de juiste privacywaarborgen.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
Gegevensprivacy
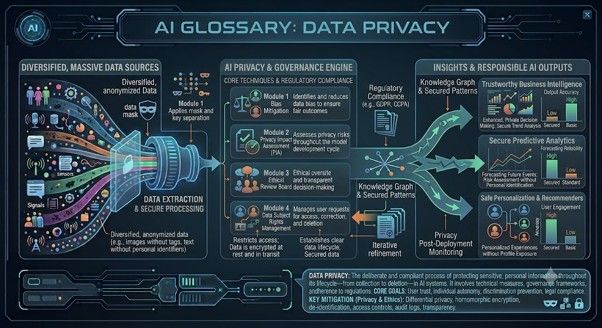
Gegevensprivacy heeft betrekking op de manier waarop persoonlijke informatie wordt verzameld, gebruikt, opgeslagen en gedeeld. AI roept nieuwe privacykwesties op, omdat modellen kunnen worden getraind op grote datasets, waaronder gevoelige informatie. Organisaties die AI gebruiken, moeten rekening houden met toestemming, beveiliging, anonimisering, bewaartermijnen en naleving van de wetgeving. Privacy is niet alleen een technische kwestie; het is een kwestie van vertrouwen.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
Dataset
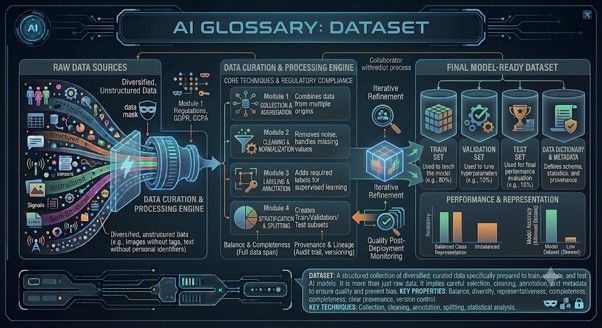
Een dataset is een gestructureerde verzameling gegevens die wordt gebruikt voor het trainen, testen of analyseren van een AI-systeem. Een dataset kan klantgegevens, medische beelden, productrecensies, financiële transacties of gelabelde foto’s bevatten. De omvang, kwaliteit en representativiteit van de dataset hebben een grote invloed op de prestaties van het model.
 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
Beslissingsboom
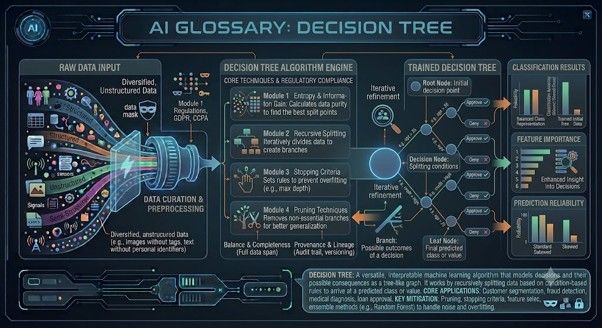
Een beslissingsboom is een machine learning-model dat beslissingen neemt aan de hand van een reeks vragen. Bijvoorbeeld: Is de klant ouder dan 18? Is de betaling eerder mislukt? Is de transactie ongewoon groot? Beslissingsbomen zijn populair omdat ze gemakkelijker te begrijpen zijn dan veel black-box-modellen. Ze worden vaak gebruikt bij risicoscores, classificatie en bedrijfsregels.
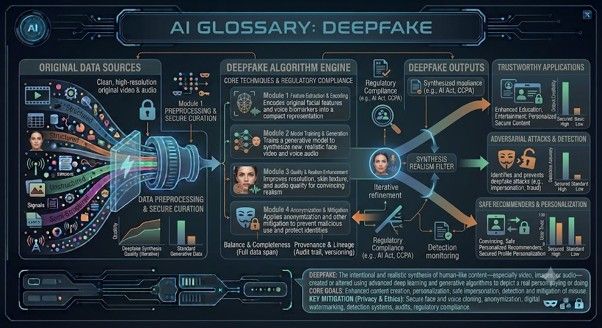 Bronvermelding: Aangeleverde afbeelding; Auteur: Stephen Whitelaw;
Deepfake
Een deepfake is door AI gegenereerde of gemanipuleerde media waardoor het lijkt alsof iemand iets zegt of doet wat hij of zij in werkelijkheid niet heeft gezegd of gedaan. Deepfakes kunnen worden gebruikt voor entertainment, maar ook voor fraude, intimidatie, desinformatie en politieke manipulatie. Naarmate deepfakes realistischer worden, worden mediageletterdheid en verificatie steeds belangrijker.
Stel The Portugal News in als uw voorkeursbron voor nieuws op Google
 Toevoegen als voorkeursbron op Google


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media