


 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
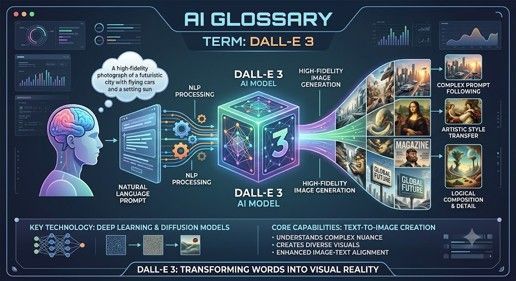
Dall-E 3
A DALL-E 3 egy, az OpenAI által kifejlesztett mélytanulási szöveg-kép modell volt, amely természetes nyelvű leírások (promptok) alapján részletes, nagy felbontású képeket generált. A 2023 végén kiadott modell jelentős előrelépést jelentett a korábbi generatív vizuális modellekhez képest, mivel jelentősen javította a promptokhoz való hűséget, a képminőséget és a komplex részletek megjelenítését.
Főbb jellemzők és képességek
· Anyanyelvi megértés: Úgy lett kialakítva, hogy a felhasználói promptokban szereplő finom árnyalatokat, térbeli viszonyokat és részletes kontextust megértse anélkül, hogy bonyolult „prompt-tervezésre” lenne szükség.
· Képben megjelenő szöveg megjelenítése: Képes tiszta, olvasható szöveget generálni, amelyet közvetlenül a képekbe ágyaz (pl. táblák, címkék, logók).
· ChatGPT-integráció: Natívan integrálva van a ChatGPT Plus/Enterprise szolgáltatásba, lehetővé téve a felhasználók számára, hogy beszélgetésszerűen ötleteljenek, finomítsanak és iteráljanak a vizuális promptokon.
· Biztonság és eredet: Beépített biztonsági korlátokkal rendelkezik, amelyek megakadályozzák a kifejezetten szexuális tartalmú anyagok, közszereplők karikatúráinak vagy élő művészek stílusának utánzásának generálását, és C2PA eredet-metadatákat használ az AI által generált képek azonosítására.
Megjegyzés: A DALL-E 3-at már többnyire nem használják szabványként, mivel az OpenAI és a Microsoft hivatalosan is kivonta a forgalomból és elavultnak nyilvánította. Helyét újabb, natív multimodális rendszerek vették át.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
Adatok
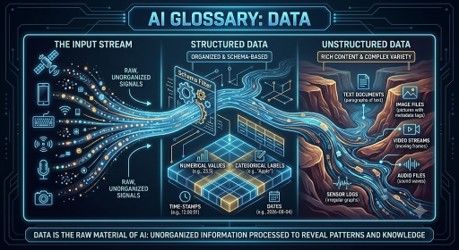
Az adatok az AI-rendszerek által használt nyersanyagok. Ide tartozhatnak szövegek, képek, hanganyagok, videók, számok, tranzakciók, érzékelőadatok vagy orvosi dokumentációk. Az AI-rendszerek az adatokból tanulják meg a mintákat. Az adatok minősége, relevanciája és méltányossága döntő fontosságú. A rossz adatok rossz AI-hez vezethetnek, függetlenül attól, hogy a modell mennyire fejlettnek tűnik.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
Adatbővítés
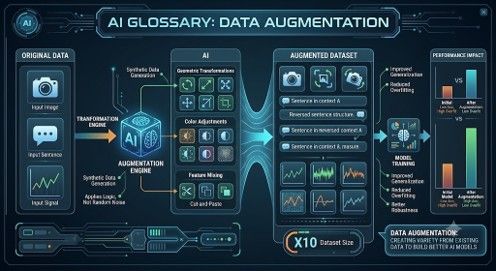
Az adatkiterjesztés azt jelenti, hogy a modell javítása érdekében módosított változatokat hozunk létre a meglévő tanulási példákból. Képek esetében ez magában foglalhatja a forgatást, a kivágást vagy a fényerő megváltoztatását. Szövegek esetében pedig a parafrazálást jelentheti. A cél az, hogy a modellt robusztusabbá tegyük azáltal, hogy változatos adatoknak tesszük ki. Az adatkiterjesztés különösen akkor hasznos, ha az eredeti adatkészlet korlátozott.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
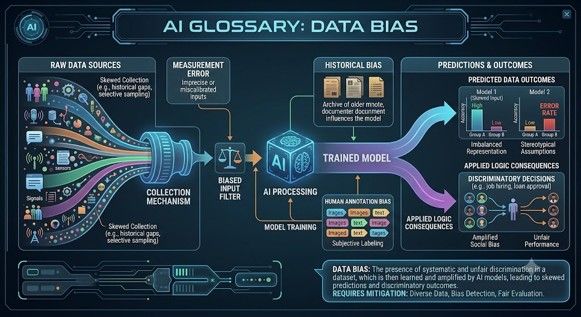
Adateltérés
Adateltérés akkor fordul elő, amikor az AI-rendszer betanításához vagy teszteléséhez használt adatok nem reprezentatívak, hiányosak vagy torzítottak. Például egy olyan arcfelismerő rendszer, amelyet főként egy demográfiai csoportra tanítottak be, más csoportok esetében rosszabb teljesítményt nyújthat. Az adateltérés az AI-rendszerek tisztességtelen vagy megbízhatatlan viselkedésének egyik fő oka.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
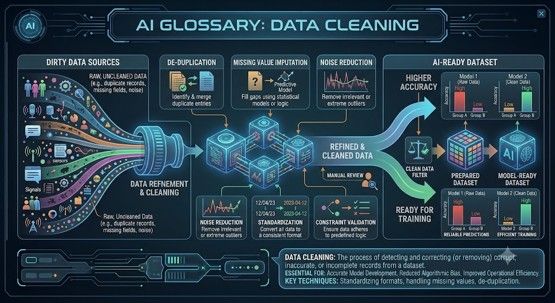
Adattisztítás
Az adat tisztítás az a folyamat, amelynek során a rendezetlen adatokat kijavítják, eltávolítják vagy rendszerezik, mielőtt azokat felhasználnák. A valós adatok gyakran tartalmaznak duplikátumokat, hiányzó értékeket, helyesírási hibákat, elavult bejegyzéseket vagy inkonzisztens formátumokat. A mesterséges intelligencia rendszerek nagymértékben függnek a tiszta adatoktól. Sok projektben az adat tisztítás több időt vesz igénybe, mint a modell felépítése.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
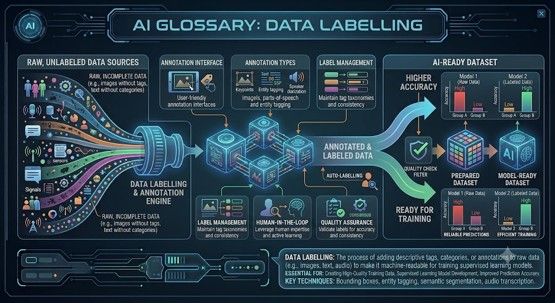
Adatcímkézés
Az adatcímkézés az a folyamat, amelynek során az adatokhoz értelmes címkéket rendelünk hozzá, hogy a mesterséges intelligencia rendszer tanulhasson belőlük. Például az e-mailek „spam” vagy „nem spam” címkézése segít a spamszűrő betanításában. Az orvosi képek címkézése pedig a diagnosztikai eszközök betanítását segíti elő. A megfelelő címkézéshez egyértelmű szabályokra és minőség-ellenőrzésre van szükség, különösen akkor, ha szakértői véleményre van szükség.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
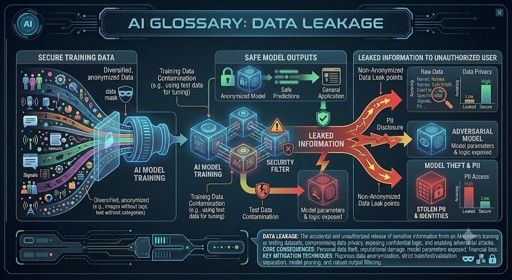
Adatszivárgás
Adatszivárgás akkor fordul elő, amikor a tesztadatokból származó információk véletlenül befolyásolják a betanítási folyamatot. Ezáltal a modell jobbnak tűnik, mint amilyen valójában. Például, ha egy modellt olyan információk felhasználásával tanítanak be, amelyek a valós életben nem állnának rendelkezésre, akkor a teljesítményére vonatkozó becslés megbízhatatlanná válik. Az adatszivárgás gyakori, de súlyos hiba a gépi tanulási projektekben.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
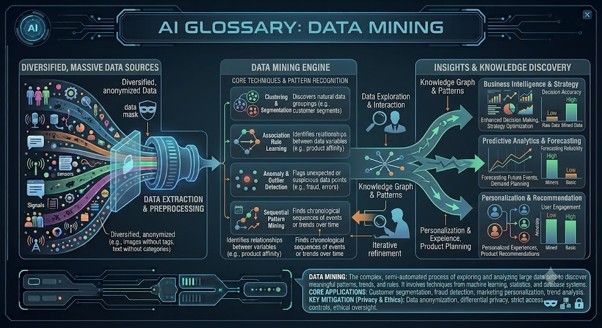
Adatbányászat
Az adatbányászat az a folyamat, amelynek során nagy adathalmazokból mintákat, összefüggéseket vagy hasznos információkat keresnek. Már a modern mesterséges intelligencia megjelenése előtt is létezett, de átfedésben van a gépi tanulással. A vállalkozások az adatbányászatot használják az ügyfelek megértésére, a csalások felderítésére, a kereslet előrejelzésére és a működés javítására. A kockázat abban rejlik, hogy a mintákat félreérthetik, vagy megfelelő adatvédelmi biztosítékok nélkül használhatják fel.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
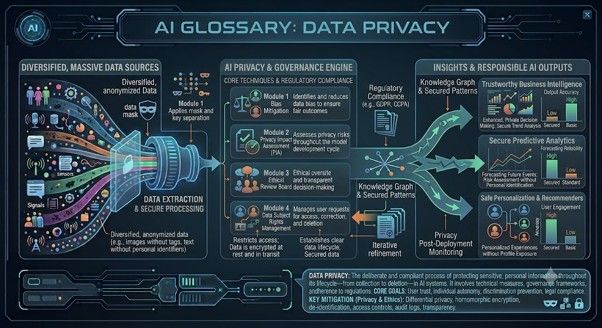
Adatvédelem
Az adatvédelem arra vonatkozik, hogy a személyes adatokat hogyan gyűjtik, használják, tárolják és osztják meg. A mesterséges intelligencia új adatvédelmi aggályokat vet fel, mivel a modelleket nagy adathalmazokon lehet betanítani, amelyek érzékeny információkat is tartalmazhatnak. A mesterséges intelligenciát alkalmazó szervezeteknek figyelembe kell venniük a hozzájárulást, a biztonságot, az anonimizálást, az adatmegőrzést és a jogi előírások betartását. Az adatvédelem nem csupán technikai kérdés; hanem bizalmi kérdés is.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
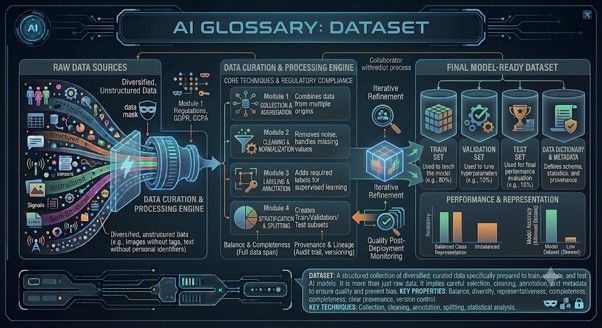
Adatkészlet
Az adatkészlet egy strukturált adatgyűjtemény, amelyet egy mesterséges intelligencia rendszer betanításához, teszteléséhez vagy elemzéséhez használnak. Az adatkészlet tartalmazhat ügyféladatokat, orvosi képeket, termékértékeléseket, pénzügyi tranzakciókat vagy címkézett fényképeket. Az adatkészlet mérete, minősége és reprezentativitása jelentősen befolyásolja a modell teljesítményét.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
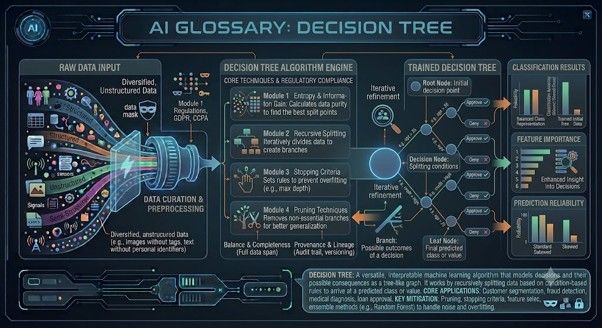
Döntési fa
A döntési fa egy olyan gépi tanulási modell, amely kérdések sorozatán keresztül hoz döntéseket. Például: Az ügyfél elmúlt-e már 18 éves? Előfordult-e már korábban fizetési hiba? Szokatlanul nagy összegű-e a tranzakció? A döntési fák népszerűek, mert könnyebben érthetőek, mint sok „fekete doboz” modell. Gyakran használják őket kockázati értékeléshez, osztályozáshoz és üzleti szabályokhoz.
 Forrás: Beküldött kép; Szerző: Stephen Whitelaw;
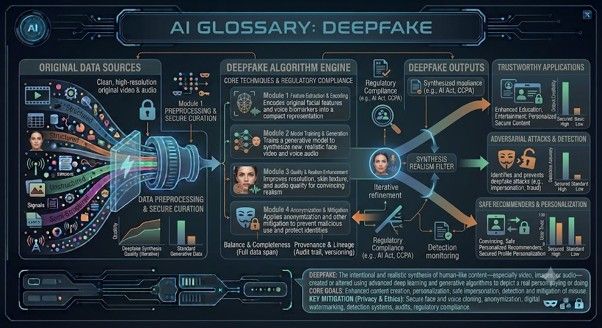
Deepfake
A deepfake egy mesterséges intelligenciával generált vagy manipulált média, amely úgy tünteti fel valakit, mintha olyasmit mondana vagy tenne, amit valójában nem mondott vagy nem tett. A deepfake-ek szórakoztatásra, de csalásra, zaklatásra, félrevezető információk terjesztésére és politikai manipulációra is felhasználhatók. Ahogy a deepfake-ek egyre valósághűbbé válnak, a médiatudatosság és a hitelesítés egyre fontosabbá válik.
Állítsa be a The Portugal News-t előnyben részesített hírforrásként a Google-on
 Hozzáadás előnyben részesített forrásként a Google-on


 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media