


 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
Dall-E 3
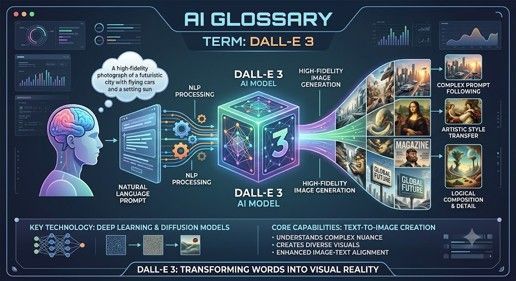
DALL-E 3 to model tekst-obraz oparty na głębokim uczeniu, opracowany przez OpenAI, który generował szczegółowe obrazy o wysokiej rozdzielczości na podstawie opisów w języku naturalnym (podpowiedzi). Wprowadzony na rynek pod koniec 2023 roku stanowił znaczący krok naprzód w stosunku do poprzednich generatywnych modeli wizualnych, znacznie poprawiając zgodność z podpowiedziami, jakość obrazów oraz renderowanie złożonych szczegółów.
Kluczowe cechy i możliwości
· Natywne rozumienie języka: Zaprojektowany tak, by natywnie rozumieć subtelne niuanse, relacje przestrzenne i szczegółowy kontekst zawarty w poleceniach użytkownika bez konieczności stosowania skomplikowanej „inżynierii poleceń”.
· Renderowanie tekstu w obrazie: Możliwość generowania wyraźnego, czytelnego tekstu osadzonego bezpośrednio w obrazach (np. znaki, etykiety, logo).
· Integracja z ChatGPT: Natywna integracja z ChatGPT Plus/Enterprise, umożliwiająca użytkownikom burzę mózgów, dopracowywanie i iterację podpowiedzi wizualnych w formie rozmowy.
· Bezpieczeństwo i pochodzenie: Zawiera wbudowane zabezpieczenia zapobiegające generowaniu treści o charakterze jednoznacznie seksualnym, karykatur osób publicznych lub imitacji stylu żyjących artystów, a także wykorzystuje metadane pochodzenia C2PA do identyfikacji obrazów wygenerowanych przez sztuczną inteligencję.
Uwaga: DALL-E 3 w większości przypadków nie jest już stosowany jako standard, ponieważ firmy OpenAI i Microsoft oficjalnie wycofały go z użytku i uznały za przestarzały. Został on zastąpiony przez nowsze, natywne systemy multimodalne
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
Dane
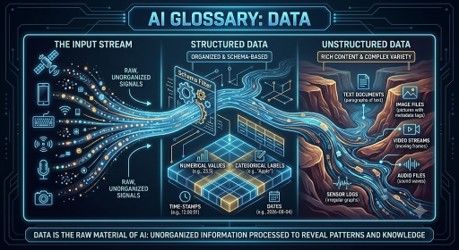
Dane to surowiec wykorzystywany przez systemy sztucznej inteligencji. Mogą one obejmować tekst, obrazy, pliki audio, wideo, liczby, transakcje, odczyty czujników lub dokumentację medyczną. Systemy sztucznej inteligencji uczą się wzorców na podstawie danych. Kluczowe znaczenie mają jakość, trafność i rzetelność danych. Złe dane mogą prowadzić do złego działania sztucznej inteligencji, niezależnie od tego, jak zaawansowany wydaje się model.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
Wzbogacanie danych
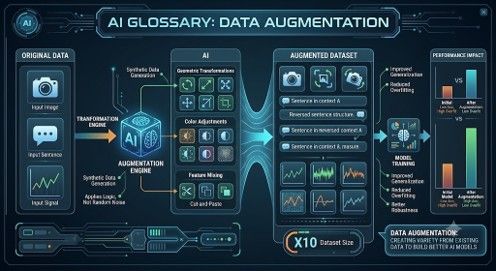
Wzbogacanie danych polega na tworzeniu zmodyfikowanych wersji istniejących przykładów szkoleniowych w celu ulepszenia modelu. W przypadku obrazów może to obejmować obracanie, kadrowanie lub zmianę jasności. W przypadku tekstu może to oznaczać parafrazowanie. Celem jest zwiększenie odporności modelu poprzez narażenie go na różnorodność. Wzbogacanie danych jest szczególnie przydatne, gdy oryginalny zbiór danych jest ograniczony.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
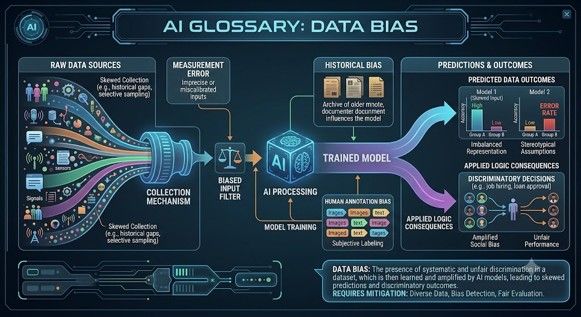
Stronniczość danych
Stronniczość danych występuje, gdy dane wykorzystywane do szkolenia lub testowania systemu sztucznej inteligencji są niereprezentatywne, niekompletne lub zniekształcone. Na przykład system rozpoznawania twarzy, wyszkolony głównie na jednej grupie demograficznej, może działać gorzej w przypadku innych grup. Stronniczość danych jest jedną z głównych przyczyn niesprawiedliwego lub niewiarygodnego zachowania sztucznej inteligencji.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
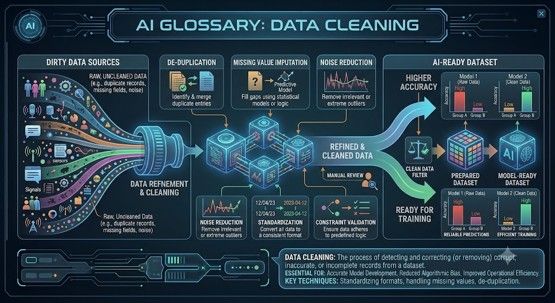
Czyszczenie danych
Czyszczenie danych to proces poprawiania, usuwania lub porządkowania nieuporządkowanych danych przed ich wykorzystaniem. Dane z rzeczywistego świata często zawierają duplikaty, brakujące wartości, błędy ortograficzne, nieaktualne wpisy lub niespójne formaty. Systemy sztucznej inteligencji w dużym stopniu opierają się na czystych danych. W wielu projektach czyszczenie danych zajmuje więcej czasu niż budowa modelu.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
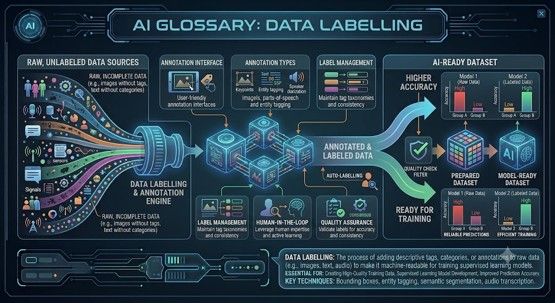
Etykietowanie danych
Etykietowanie danych to proces dodawania do danych znaczących tagów, aby system AI mógł się na nich uczyć. Na przykład oznaczanie wiadomości e-mail jako „spam” lub „nie jest spamem” pomaga w szkoleniu filtra antyspamowego. Etykietowanie obrazów medycznych może pomóc w szkoleniu narzędzi diagnostycznych. Dobre etykietowanie wymaga jasnych zasad i kontroli jakości, zwłaszcza gdy konieczna jest ocena eksperta.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
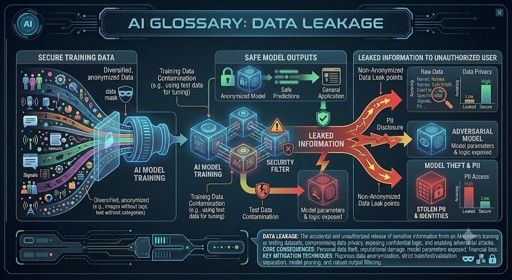
Wyciek danych
Wyciek danych ma miejsce, gdy informacje pochodzące z danych testowych przypadkowo wpływają na proces uczenia. Sprawia to, że model wydaje się lepszy, niż jest w rzeczywistości. Na przykład, jeśli model jest trenowany przy użyciu informacji, które nie byłyby dostępne w rzeczywistych warunkach, oszacowanie jego wydajności staje się niewiarygodne. Wyciek danych jest powszechnym, ale poważnym błędem w projektach uczenia maszynowego.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
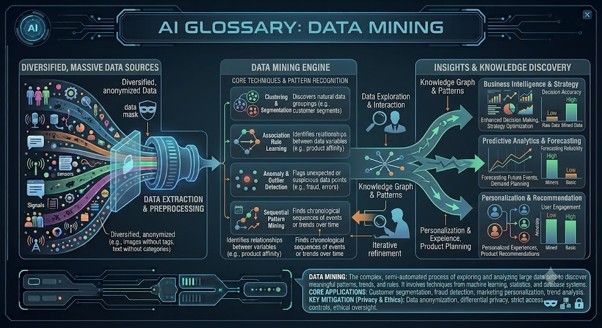
Eksploracja danych
Eksploracja danych to proces polegający na wyszukiwaniu wzorców, powiązań lub przydatnych informacji w dużych zbiorach danych. Istniała ona już przed pojawieniem się współczesnej sztucznej inteligencji, ale pokrywa się z uczeniem maszynowym. Firmy wykorzystują eksplorację danych do zrozumienia klientów, wykrywania oszustw, prognozowania popytu i usprawniania działalności. Ryzyko polega na tym, że wzorce mogą zostać błędnie zinterpretowane lub wykorzystane bez odpowiednich zabezpieczeń prywatności.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
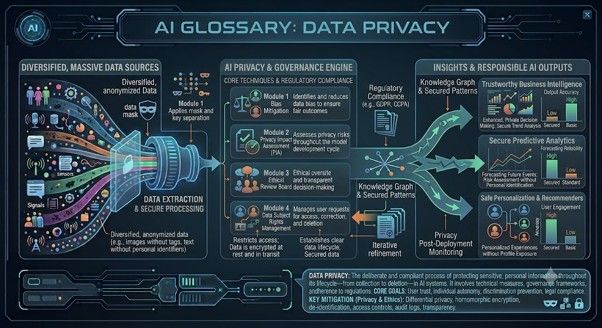
Ochrona danych
Ochrona danych dotyczy sposobu gromadzenia, wykorzystywania, przechowywania i udostępniania danych osobowych. Sztuczna inteligencja rodzi nowe obawy dotyczące prywatności, ponieważ modele mogą być trenowane na dużych zbiorach danych, w tym zawierających informacje wrażliwe. Organizacje korzystające ze sztucznej inteligencji muszą uwzględniać kwestie zgody, bezpieczeństwa, anonimizacji, okresu przechowywania danych oraz zgodności z przepisami prawa. Ochrona danych to nie tylko kwestia techniczna; to kwestia zaufania.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
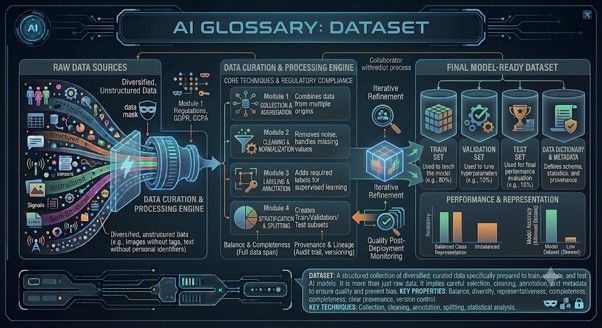
Zbiór danych
Zbiór danych to uporządkowany zbiór danych wykorzystywany do szkolenia, testowania lub analizowania systemu sztucznej inteligencji. Zbiór danych może zawierać dane klientów, obrazy medyczne, recenzje produktów, transakcje finansowe lub opatrzone etykietami zdjęcia. Wielkość, jakość i reprezentatywność zbioru danych mają duży wpływ na wydajność modelu.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
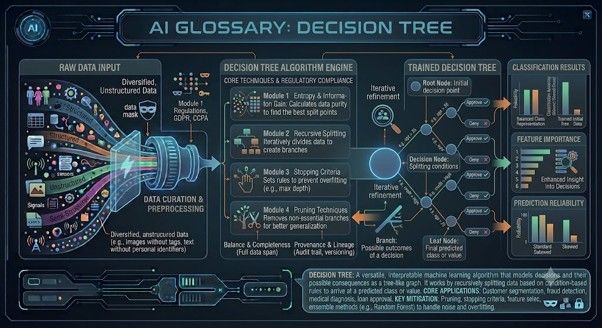
Drzewo decyzyjne
Drzewo decyzyjne to model uczenia maszynowego, który podejmuje decyzje poprzez sekwencję pytań. Na przykład: Czy klient ma ponad 18 lat? Czy płatność nie powiodła się wcześniej? Czy transakcja jest niezwykle duża? Drzewa decyzyjne są popularne, ponieważ są łatwiejsze do zrozumienia niż wiele modeli typu „czarna skrzynka”. Są one często wykorzystywane w ocenie ryzyka, klasyfikacji i regułach biznesowych.
 Źródło: Zdjęcie udostępnione; Autor: Stephen Whitelaw;
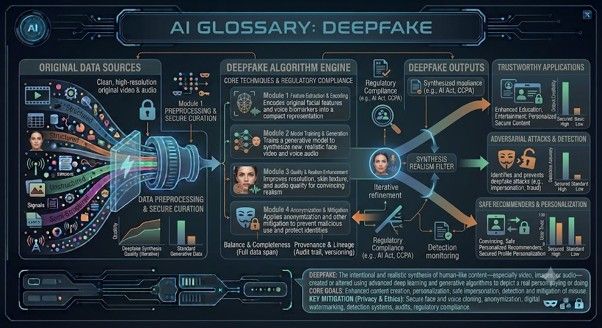
Deepfake
Deepfake to treści multimedialne wygenerowane lub zmodyfikowane przez sztuczną inteligencję, które sprawiają, że dana osoba wydaje się mówić lub robić coś, czego w rzeczywistości nie powiedziała ani nie zrobiła. Deepfake’i mogą być wykorzystywane w celach rozrywkowych, ale także do oszustw, nękania, rozpowszechniania dezinformacji i manipulacji politycznej. W miarę jak deepfake’i stają się coraz bardziej realistyczne, coraz większego znaczenia nabierają umiejętność krytycznej oceny mediów oraz weryfikacja informacji.
Ustaw The Portugal News jako preferowane źródło wiadomości w Google
 Dodaj jako preferowane źródło w Google





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media