


 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
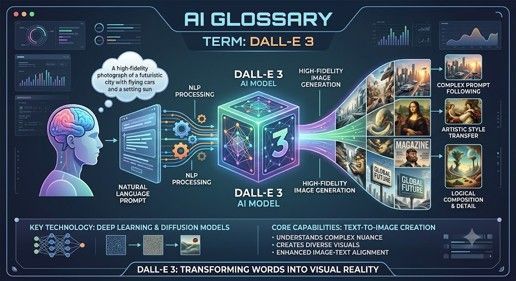
Dall-E 3
DALL-E 3 — это модель глубокого обучения для преобразования текста в изображение, разработанная OpenAI, которая генерировала детализированные изображения высокого разрешения на основе описаний на естественном языке (подсказок). Выпущенная в конце 2023 года, она стала значительным усовершенствованием по сравнению с предыдущими генеративными визуальными моделями благодаря существенному улучшению соответствия подсказкам, качества изображений и прорисовки сложных деталей.
Основные особенности и возможности
· Понимание естественного языка: изначально создана для понимания тонких нюансов, пространственных отношений и детального контекста в запросах пользователей без необходимости сложной «инженерии подсказок».
· Отображение текста на изображении: способна генерировать четкий и разборчивый текст, встроенный непосредственно в изображения (например, вывески, надписи, логотипы).
· Интеграция с ChatGPT: встроенная интеграция с ChatGPT Plus/Enterprise, позволяющая пользователям в диалоговом режиме проводить мозговой штурм, дорабатывать и итеративно совершенствовать визуальные запросы.
· Безопасность и прослеживаемость происхождения: включает встроенные меры безопасности, предотвращающие генерацию контента откровенного характера, карикатур на общественных деятелей или имитацию стиля живых художников, а также использует метаданные прослеживаемости происхождения C2PA для идентификации изображений, сгенерированных ИИ.
Примечание. DALL-E 3 в основном больше не используется в качестве стандарта, поскольку OpenAI и Microsoft официально сняли его с производства и объявили устаревшим. Его заменили более новые встроенные мультимодальные системы
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
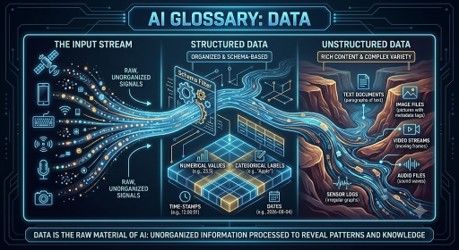
Данные
Данные — это исходный материал, используемый системами ИИ. Они могут включать текст, изображения, аудио, видео, числа, транзакции, показания датчиков или медицинские записи. Системы ИИ выделяют закономерности на основе данных. Качество, релевантность и объективность данных имеют решающее значение. Некачественные данные могут привести к некачественной работе ИИ, независимо от того, насколько продвинутой кажется модель.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
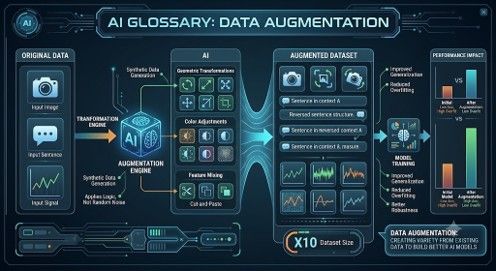
Расширение данных
Расширение данных означает создание модифицированных версий существующих обучающих примеров для улучшения модели. В случае изображений это может включать поворот, кадрирование или изменение яркости. В случае текста — перефразирование. Цель состоит в том, чтобы сделать модель более устойчивой, подвергая её различным вариациям. Расширение данных особенно полезно, когда исходный набор данных ограничен.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
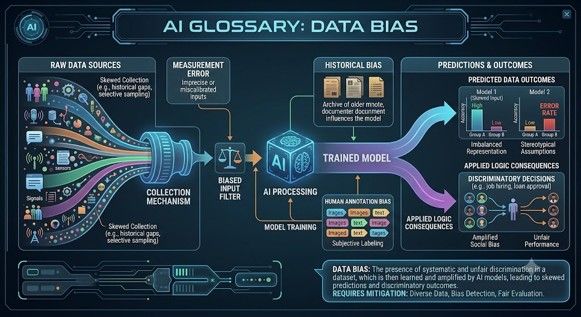
Смещение данных
Смещение данных возникает, когда данные, используемые для обучения или тестирования системы ИИ, являются нерепрезентативными, неполными или искажёнными. Например, система распознавания лиц, обученная преимущественно на одной демографической группе, может демонстрировать худшие результаты при работе с другими группами. Смещение данных является одной из основных причин несправедливого или ненадежного поведения ИИ.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
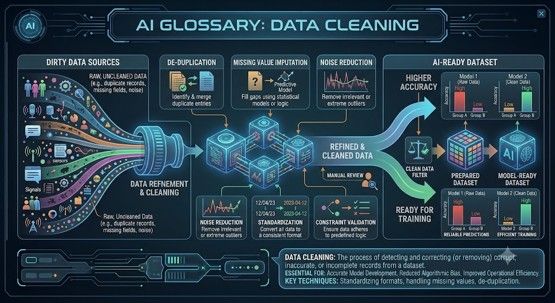
Очистка данных
Очистка данных — это процесс исправления, удаления или упорядочивания неструктурированных данных перед их использованием. Реальные данные часто содержат дубликаты, пропущенные значения, орфографические ошибки, устаревшие записи или несогласованные форматы. Системы ИИ в значительной степени зависят от чистых данных. Во многих проектах очистка данных занимает больше времени, чем построение модели.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
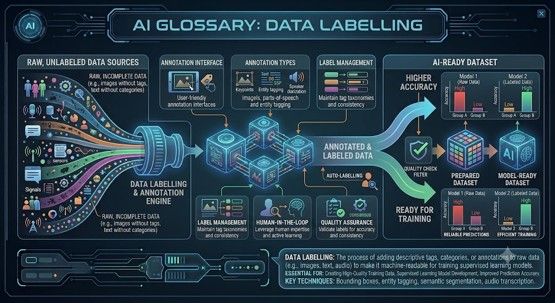
Маркировка данных
Маркировка данных — это процесс добавления к данным значимых меток, чтобы система искусственного интеллекта могла учиться на них. Например, маркировка электронных писем как «спам» или «не спам» помогает обучить спам-фильтр. Маркировка медицинских изображений может помочь в обучении диагностических инструментов. Для качественной маркировки необходимы чёткие правила и контроль качества, особенно когда требуется экспертная оценка.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
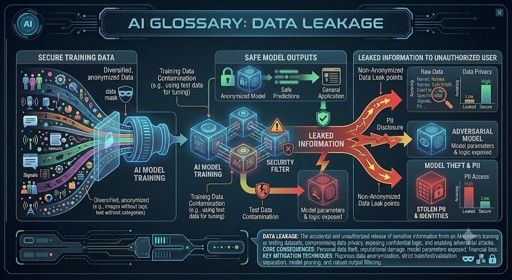
Утечка данных
Утечка данных происходит, когда информация из тестовых данных случайно влияет на процесс обучения. Это приводит к тому, что модель выглядит лучше, чем она есть на самом деле. Например, если модель обучается с использованием информации, которая в реальной жизни была бы недоступна, оценка её эффективности становится недостоверной. Утечка данных — распространённая, но серьёзная ошибка в проектах машинного обучения.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
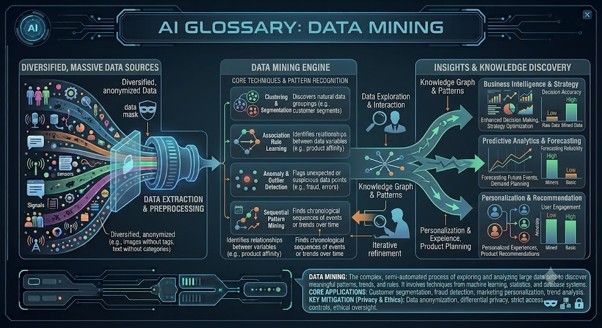
Интеллектуальный анализ данных
Интеллектуальный анализ данных — это процесс поиска закономерностей, взаимосвязей или полезной информации в больших наборах данных. Он существовал ещё до появления современного ИИ, но пересекается с машинным обучением. Компании используют интеллектуальный анализ данных для понимания клиентов, выявления мошенничества, прогнозирования спроса и оптимизации операционной деятельности. Риск заключается в том, что закономерности могут быть неверно интерпретированы или использованы без надлежащих мер по защите конфиденциальности.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
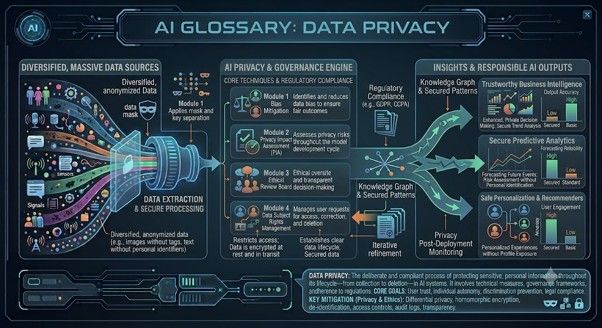
Конфиденциальность данных
Конфиденциальность данных касается того, как собирается, используется, хранится и передается личная информация. ИИ порождает новые проблемы в области конфиденциальности, поскольку модели могут обучаться на больших наборах данных, включая конфиденциальную информацию. Организации, использующие ИИ, должны учитывать вопросы согласия, безопасности, анонимизации, хранения данных и соблюдения законодательства. Конфиденциальность — это не только техническая проблема, но и вопрос доверия.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
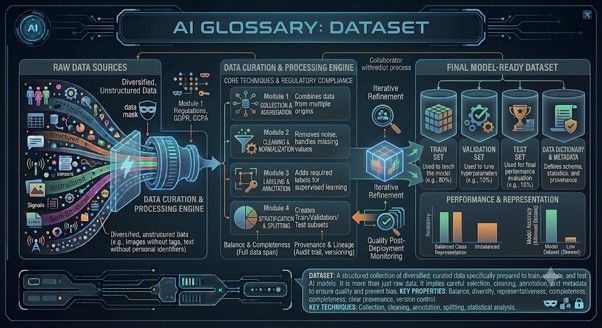
Набор данных
Набор данных — это структурированное собрание данных, используемое для обучения, тестирования или анализа системы ИИ. Набор данных может содержать записи о клиентах, медицинские изображения, отзывы о продуктах, финансовые транзакции или фотографии с метками. Размер, качество и репрезентативность набора данных сильно влияют на эффективность модели.
 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
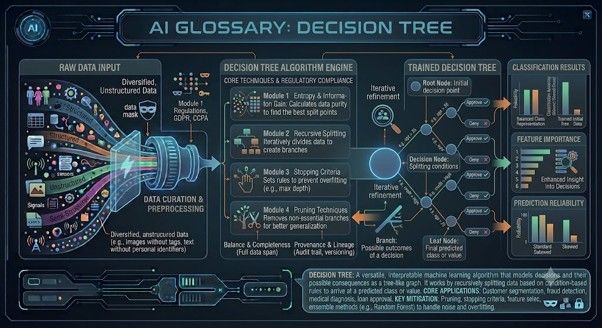
Дерево решений
Дерево решений — это модель машинного обучения, которая принимает решения посредством последовательности вопросов. Например: «Достиг ли клиент 18 лет?», «Были ли ранее неудачные попытки оплаты?», «Является ли транзакция необычно крупной?». Деревья решений популярны, поскольку их легче понять, чем многие модели типа «черный ящик». Они часто используются для оценки рисков, классификации и реализации бизнес-правил.
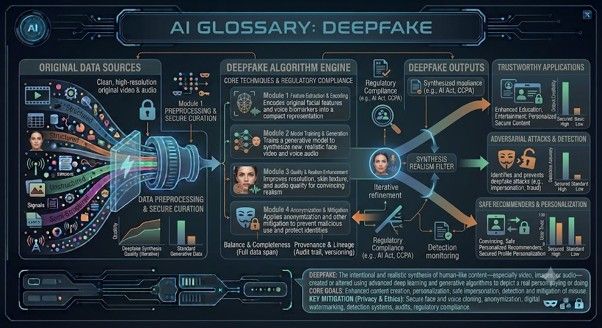 Источник: предоставленное изображение; автор: Стивен Уайтлоу;
Дипфейк
Дипфейк — это медиаконтент, сгенерированный или обработанный с помощью искусственного интеллекта, который создает впечатление, будто человек говорит или делает то, чего на самом деле не говорил и не делал. Дипфейки могут использоваться в развлекательных целях, но также и для мошенничества, преследования, дезинформации и политических манипуляций. По мере того как дипфейки становятся всё более реалистичными, медиаграмотность и проверка информации приобретают всё большее значение.
Установите The Portugal News в качестве предпочтительного источника новостей в Google
 Добавить как предпочтительный источник в Google





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media