


 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
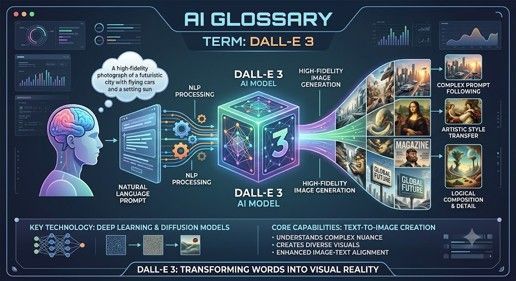
Dall-E 3
DALL-E 3 oli OpenAI:n kehittämä syväoppimiseen perustuva tekstistä kuvaksi -malli, joka tuotti yksityiskohtaisia, korkean resoluution kuvia luonnollisen kielen kuvauksista (promptit). Vuoden 2023 lopulla julkaistu malli edusti merkittävää kehitysvaihetta aiempiin generatiivisiin visuaalisiin malleihin verrattuna, sillä se paransi huomattavasti promptien noudattamista, kuvanlaatua ja monimutkaisten yksityiskohtien renderointia.
Tärkeimmät ominaisuudet ja toiminnot
· Äidinkielen ymmärtäminen: Suunniteltu alun perin ymmärtämään käyttäjän kehotteiden hienovaraisia vivahteita, tilallisia suhteita ja yksityiskohtaista kontekstia ilman monimutkaista ”kehotteiden muokkausta”.
· Tekstin renderointi kuvan sisällä: Pystyy tuottamaan selkeää, luettavissa olevaa tekstiä, joka on upotettu suoraan kuvien sisään (esim. kyltit, etiketit, logot).
· ChatGPT-integraatio: Integroitu natiivisti ChatGPT Plus/Enterprise -palveluun, minkä ansiosta käyttäjät voivat ideoida, hioa ja kehittää visuaalisia kehotteita keskustelunomaisesti.
· Turvallisuus ja alkuperä: Sisältää sisäänrakennetut turvatoiminnot, jotka estävät eksplisiittisen sisällön, julkisuuden henkilöiden karikatyyrien tai elävien taiteilijoiden tyylin jäljittelyn luomisen, ja käyttää C2PA-alkuperämetatietoja tunnistamaan tekoälyn luomia kuvia.
Huom. DALL-E 3:a ei enää käytetä standardina, koska OpenAI ja Microsoft ovat virallisesti lopettaneet sen käytön ja julistaneet sen vanhentuneeksi. Se on korvattu uudemmilla natiivisilla multimodaalisilla järjestelmillä
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
Data
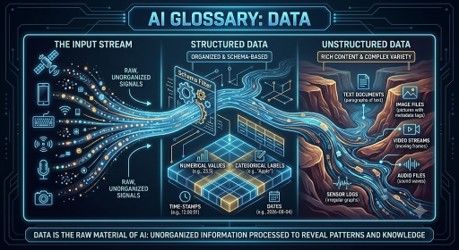
Data on tekoälyjärjestelmien käyttämä raaka-aine. Se voi sisältää tekstiä, kuvia, ääntä, videota, lukuja, tapahtumia, anturilukemia tai potilastietoja. Tekoälyjärjestelmät oppivat malleja datasta. Datan laatu, relevanssi ja oikeudenmukaisuus ovat ratkaisevan tärkeitä. Huono data voi johtaa huonoon tekoälyyn, riippumatta siitä, kuinka edistyneeltä malli näyttää.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
Datan laajennus
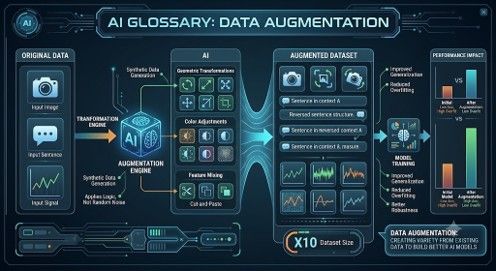
Datan laajentamisella tarkoitetaan olemassa olevien koulutusesimerkkien muokkaamista mallin parantamiseksi. Kuvien kohdalla tämä voi tarkoittaa kiertämistä, rajaamista tai kirkkauden muuttamista. Tekstin kohdalla se voi tarkoittaa parafraasointia. Tavoitteena on tehdä mallista vankempi altistamalla se vaihtelulle. Datan laajentaminen on erityisen hyödyllistä, kun alkuperäinen aineisto on rajallinen.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
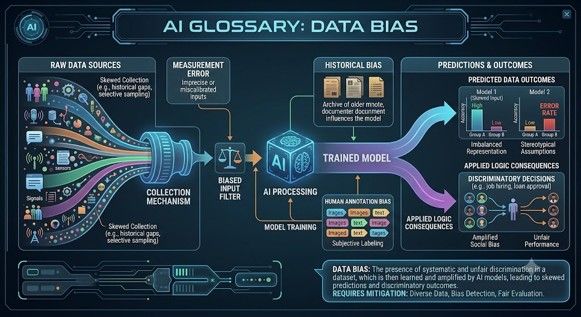
Datan harha
Datan harha syntyy, kun tekoälyjärjestelmän kouluttamiseen tai testaamiseen käytetty data ei ole edustavaa, on puutteellista tai vinoutunutta. Esimerkiksi kasvojentunnistusjärjestelmä, joka on koulutettu pääasiassa yhtä väestöryhmää varten, saattaa toimia huonommin muiden ryhmien kohdalla. Datan harha on yksi tärkeimmistä syistä tekoälyn epäoikeudenmukaiseen tai epäluotettavaan käyttäytymiseen.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
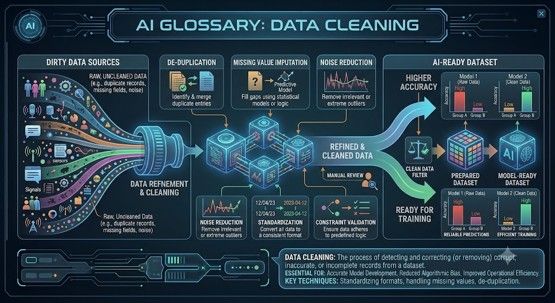
Tietojen puhdistus
Tietojen puhdistaminen on prosessi, jossa epäjärjestyksessä olevia tietoja korjataan, poistetaan tai järjestellään ennen niiden käyttöä. Todellisesta maailmasta peräisin olevat tiedot sisältävät usein päällekkäisyyksiä, puuttuvia arvoja, kirjoitusvirheitä, vanhentuneita merkintöjä tai epäjohdonmukaisia muotoja. Tekoälyjärjestelmät ovat suuresti riippuvaisia puhtaista tiedoista. Monissa projekteissa tietojen puhdistaminen vie enemmän aikaa kuin mallin rakentaminen.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
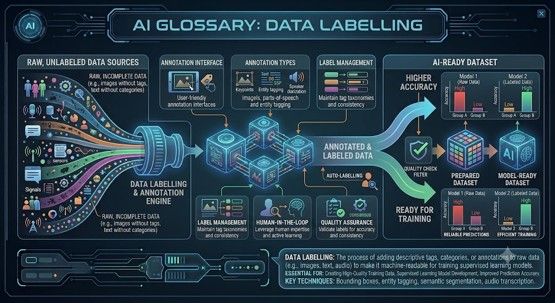
Tietojen merkitseminen
Tietojen merkitseminen on prosessi, jossa dataan lisätään merkityksellisiä tunnisteita, jotta tekoälyjärjestelmä voi oppia siitä. Esimerkiksi sähköpostiviestien merkitseminen ”roskapostiksi” tai ”ei roskapostiksi” auttaa kouluttamaan roskapostisuodatinta. Lääketieteellisten kuvien merkitseminen voi auttaa kouluttamaan diagnoosityökaluja. Hyvä merkitseminen vaatii selkeitä sääntöjä ja laadunvalvontaa, erityisesti silloin, kun tarvitaan asiantuntijan arviointia.
 Kuvateksti: Toimitettu kuva; Tekijä: Stephen Whitelaw;
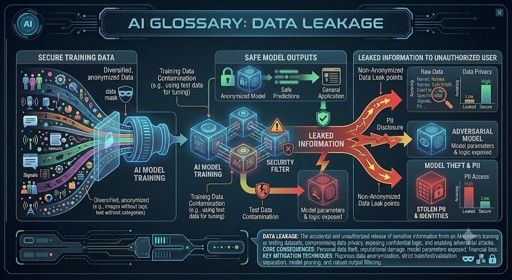
Tietovuoto
Tietovuoto tapahtuu, kun testitiedoista peräisin oleva informaatio vaikuttaa vahingossa koulutusprosessiin. Tämä saa mallin näyttämään paremmalta kuin se todellisuudessa on. Esimerkiksi jos malli koulutetaan käyttämällä tietoa, jota ei olisi saatavilla todellisessa elämässä, sen suorituskykyarvio muuttuu epäluotettavaksi. Tietovuoto on yleinen mutta vakava virhe koneoppimisprojekteissa.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
Tietojen louhinta
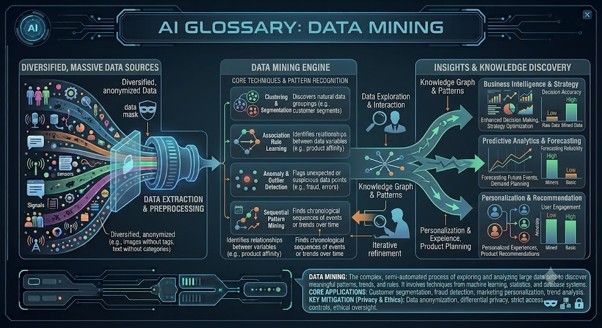
Tiedonlouhinta on prosessi, jossa suurista tietojoukoista etsitään malleja, yhteyksiä tai hyödyllistä tietoa. Se oli olemassa jo ennen nykyaikaista tekoälyä, mutta se limittyy koneoppimisen kanssa. Yritykset käyttävät tiedonlouhintaa asiakkaiden ymmärtämiseen, petosten havaitsemiseen, kysynnän ennustamiseen ja toimintojen parantamiseen. Riskinä on, että malleja saatetaan tulkita väärin tai käyttää ilman asianmukaisia tietosuojatoimenpiteitä.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
Tietosuoja
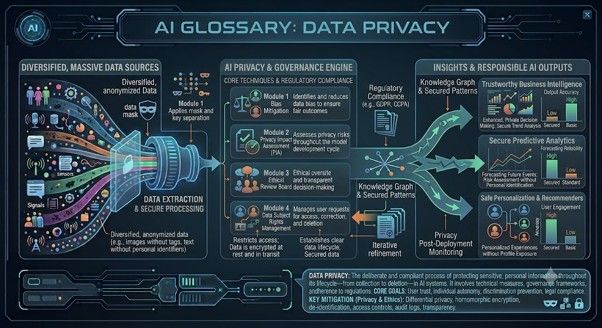
Tietosuoja koskee sitä, miten henkilötietoja kerätään, käytetään, säilytetään ja jaetaan. Tekoäly herättää uusia tietosuojaan liittyviä huolenaiheita, koska malleja saatetaan kouluttaa suurilla tietojoukoilla, jotka sisältävät arkaluonteisia tietoja. Tekoälyä käyttävien organisaatioiden on otettava huomioon suostumus, tietoturva, anonymisointi, tietojen säilyttäminen ja lainsäädännön noudattaminen. Tietosuoja ei ole pelkästään tekninen kysymys, vaan kyse on luottamuksesta.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
Aineisto
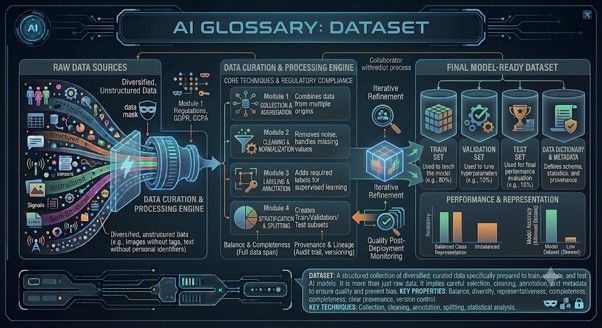
Aineisto on jäsennelty tietokokoelma, jota käytetään tekoälyjärjestelmän kouluttamiseen, testaamiseen tai analysointiin. Aineisto voi sisältää asiakastietoja, lääketieteellisiä kuvia, tuotearvosteluja, rahoitustapahtumia tai luokiteltuja valokuvia. Aineiston koko, laatu ja edustavuus vaikuttavat voimakkaasti mallin suorituskykyyn.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
Päätöspuu
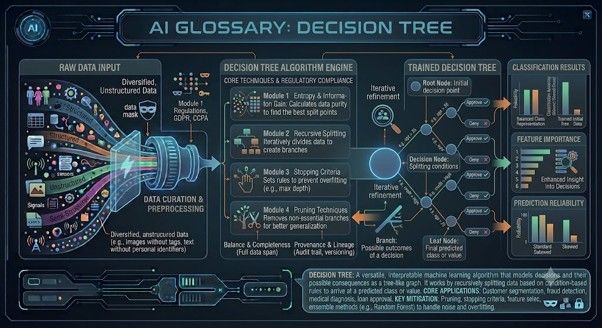
Päätöspuu on koneoppimismalli, joka tekee päätöksiä kysymyssarjan avulla. Esimerkiksi: Onko asiakas yli 18-vuotias? Onko maksu epäonnistunut aiemmin? Onko tapahtuma epätavallisen suuri? Päätöspuut ovat suosittuja, koska ne ovat helpommin ymmärrettäviä kuin monet black-box-mallit. Niitä käytetään usein riskien arvioinnissa, luokittelussa ja liiketoimintasäännöissä.
 Lähde: Toimitettu kuva; Tekijä: Stephen Whitelaw;
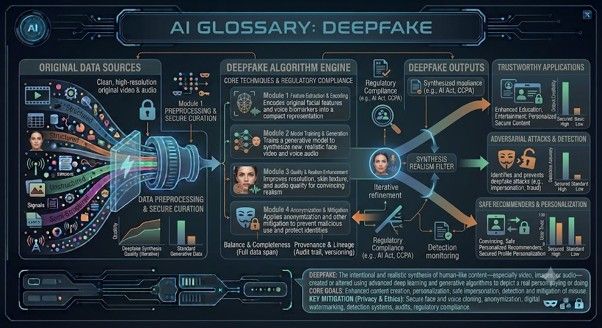
Deepfake
Deepfake on tekoälyn luoma tai manipuloima media, joka saa jonkun näyttämään siltä, kuin hän sanoisi tai tekisi jotain, mitä hän ei ole sanonut tai tehnyt. Deepfake-sisältöä voidaan käyttää viihteenä, mutta myös petoksiin, häirintään, väärän tiedon levittämiseen ja poliittiseen manipulointiin. Deepfake-sisällön realistisuuden kasvaessa medialukutaito ja tiedon tarkistaminen tulevat yhä tärkeämmiksi.
Aseta The Portugal News ensisijaiseksi uutislähteeksesi Googlessa
 Lisää ensisijaiseksi lähteeksi Googlessa





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media