


 图片来源:供图;作者:斯蒂芬·惠特洛;
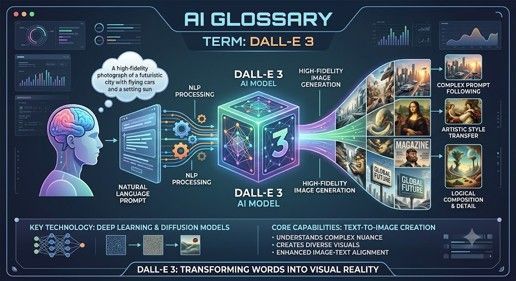
Dall-E 3
DALL-E 3是 OpenAI 开发的一款深度学习文本到图像模型,能够根据自然语言描述(提示词)生成详细、高分辨率的图像。该模型于 2023 年末发布,通过显著提升提示词遵循度、图像质量以及复杂细节的渲染能力,代表了相较于此前生成式视觉模型的一次重大迭代。
主要特点与功能
· 原生语言理解:原生设计可理解用户提示中的细微差别、空间关系和详细上下文,无需复杂的“提示工程”。
· 图像内文本渲染:能够生成清晰、易读的文本,并将其直接嵌入图像中(例如:标识、标签、徽标)。
· 与 ChatGPT 集成:原生集成于 ChatGPT Plus/Enterprise,允许用户通过对话方式对视觉提示进行头脑风暴、优化和迭代。
· 安全与来源追溯:内置安全防护机制,防止生成露骨内容、公众人物的讽刺漫画或模仿在世艺术家的画风;并采用 C2PA 来源元数据来标识 AI 生成的图像。
注:DALL-E 3 目前已基本不再作为标准使用,因为 OpenAI 和微软已正式将其退役并弃用。它已被更新的原生多模态系统所取代
 来源:供图;作者:Stephen Whitelaw;
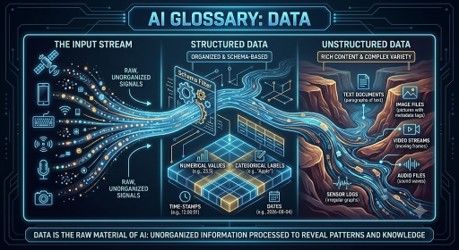
数据
数据是人工智能系统所使用的原材料。它可能包括文本、图像、音频、视频、数字、交易记录、传感器读数或医疗记录。人工智能系统从数据中学习模式。数据的质量、相关性和公平性至关重要。无论模型看似多么先进,劣质数据都会导致人工智能表现不佳。
 图片来源:供图;作者:斯蒂芬·怀特劳;
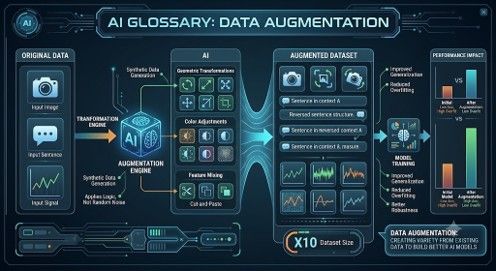
数据增强
数据增强是指通过创建现有训练样本的修改版本来改进模型。对于图像,这可能包括旋转、裁剪或调整亮度;对于文本,则可能涉及改写。其目的是通过让模型接触各种变体,从而提高其鲁棒性。当原始数据集有限时,数据增强尤为有用。
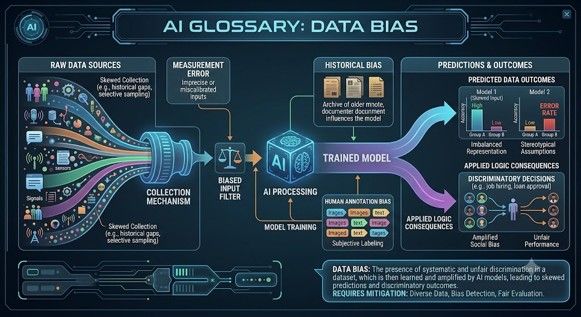 图片来源:供图;作者:斯蒂芬·怀特劳;
数据偏差
当用于训练或测试人工智能系统的数据缺乏代表性、不完整或存在偏差时,就会产生数据偏差。例如,主要基于某一人口统计群体进行训练的面部识别系统,在其他群体上的表现可能会较差。数据偏差是导致人工智能行为不公平或不可靠的主要原因之一。
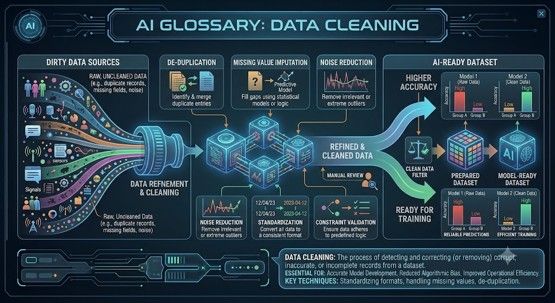 来源:图片由供稿方提供;作者:斯蒂芬·怀特劳;
数据清洗
数据清洗是指在使用数据之前对其进行修正、删除或整理的过程。现实世界中的数据通常包含重复项、缺失值、拼写错误、过时条目或格式不一致的情况。人工智能系统在很大程度上依赖于干净的数据。在许多项目中,数据清洗所花费的时间甚至比构建模型还要长。
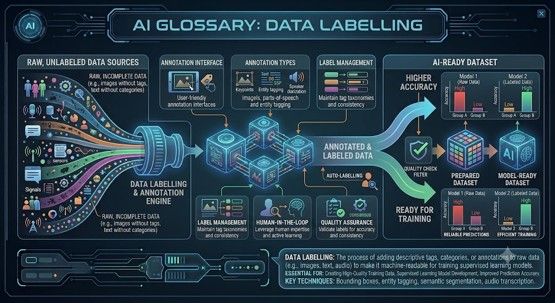 来源:供图;作者:斯蒂芬·怀特劳;
数据标注
数据标注是指为数据添加有意义的标签,以便人工智能系统能够从中学习。例如,将电子邮件标注为“垃圾邮件”或“非垃圾邮件”,有助于训练垃圾邮件过滤器。对医学影像进行标注则有助于训练诊断工具。良好的标注需要明确的规则和质量控制,尤其是在需要专家判断的情况下。
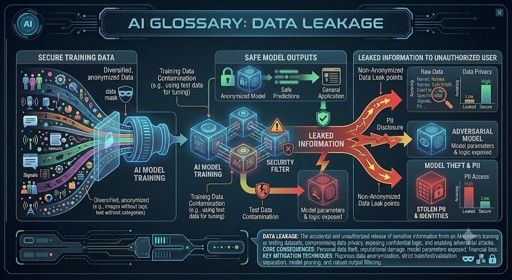 图片来源:供图;作者:斯蒂芬·怀特劳;
数据泄漏
当测试数据中的信息意外地影响了训练过程时,就会发生数据泄漏。这会使模型的表现看起来比实际更好。例如,如果模型使用在现实生活中无法获得的信息进行训练,其性能估计就会变得不可靠。数据泄漏是机器学习项目中常见但严重的错误。
 来源:供图;作者:斯蒂芬·怀特劳;
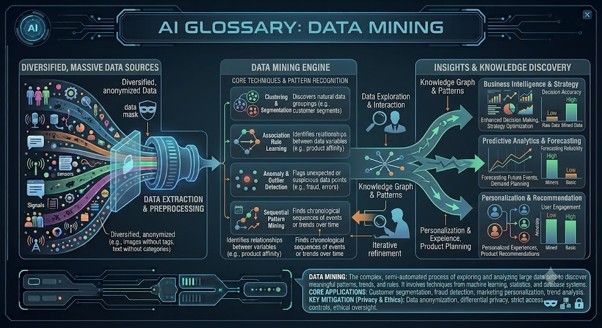
数据挖掘
数据挖掘是指从海量数据集中发现模式、关联或有用信息的过程。它早于现代人工智能出现,但与机器学习存在交叉。企业利用数据挖掘来了解客户、检测欺诈、预测需求并优化运营。其风险在于,这些模式可能会被误解,或在缺乏适当隐私保护措施的情况下被滥用。
 来源:供图;作者:斯蒂芬·怀特劳;
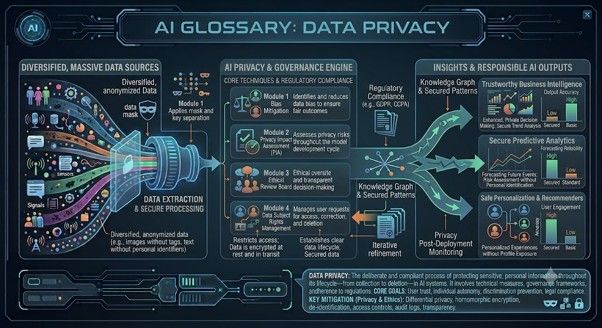
数据隐私
数据隐私涉及个人信息的收集、使用、存储和共享方式。人工智能带来了新的隐私问题,因为模型可能基于包含敏感信息的大型数据集进行训练。使用人工智能的组织需要考虑同意、安全、匿名化、数据保留以及法律合规性。隐私不仅仅是一个技术问题,更是一个信任问题。
 图片来源:供图;作者:斯蒂芬·怀特劳;
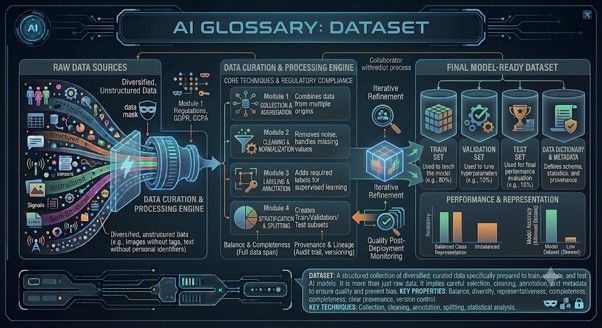
数据集
数据集是指用于训练、测试或分析人工智能系统的结构化数据集合。数据集可能包含客户记录、医学影像、产品评论、金融交易或标注过的照片。数据集的规模、质量和代表性会极大影响模型的性能。
 来源:供图;作者:斯蒂芬·怀特劳;
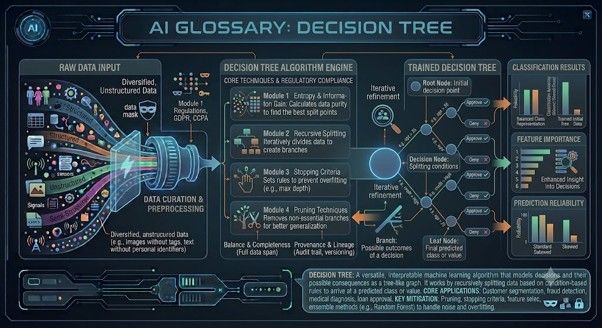
决策树
决策树是一种通过一系列问题进行决策的机器学习模型。例如:客户是否年满18岁?之前是否出现过支付失败的情况?交易金额是否异常庞大?决策树之所以广受欢迎,是因为它们比许多“黑箱”模型更易于理解。它们常用于风险评分、分类和业务规则中。
 来源:供图;作者:斯蒂芬·怀特劳;
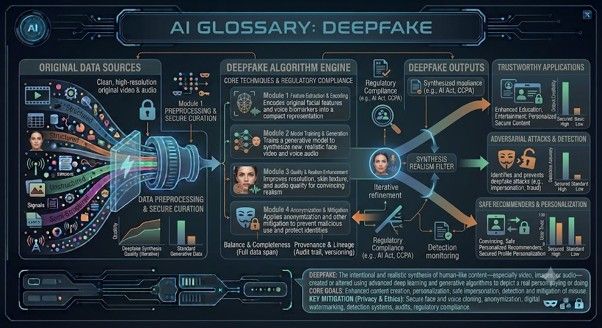
深度伪造
深度伪造是指由人工智能生成或篡改的媒体内容,使某人看似说了或做了实际上并未说过或做过的事情。 深度伪造既可用于娱乐,也可用于欺诈、骚扰、散布虚假信息以及政治操纵。随着深度伪造技术日益逼真,媒体素养和信息核实变得愈发重要。
将 The Portugal News 设为您在 Google 上的首选新闻来源
 在 Google 上添加为首选来源





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media