


 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
Dall-E 3
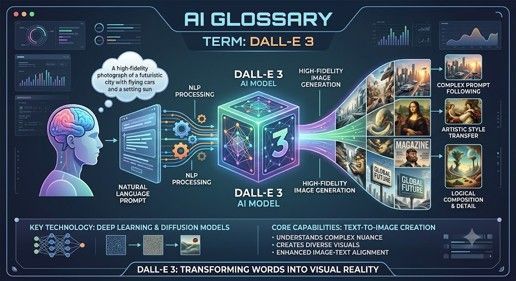
DALL-E 3 fue un modelo de aprendizaje profundo de conversión de texto a imagen desarrollado por OpenAI que generaba imágenes detalladas y de alta resolución a partir de descripciones en lenguaje natural (indicaciones). Lanzado a finales de 2023, supuso una importante mejora con respecto a los modelos visuales generativos anteriores, ya que mejoró significativamente la fidelidad a las indicaciones, la calidad de la imagen y la representación de detalles complejos.
Características y capacidades clave
· Comprensión del lenguaje natural: Diseñado de forma nativa para comprender matices sutiles, relaciones espaciales y contexto detallado dentro de las indicaciones de los usuarios sin necesidad de una compleja «ingeniería de indicaciones».
· Representación de texto en imágenes: capaz de generar texto claro y legible incrustado directamente en las imágenes (por ejemplo, carteles, etiquetas o logotipos).
· Integración con ChatGPT: Integrado de forma nativa en ChatGPT Plus/Enterprise, lo que permite a los usuarios generar ideas, perfeccionar y refinar las indicaciones visuales de forma conversacional.
· Seguridad y procedencia: Incorpora medidas de seguridad integradas para evitar la generación de contenido explícito, caricaturas de figuras públicas o imitaciones del estilo de artistas vivos, y utiliza metadatos de procedencia C2PA para identificar imágenes generadas por IA.
Nota: DALL-E 3 ya casi no se utiliza como estándar, ya que OpenAI y Microsoft lo han retirado oficialmente y lo han declarado obsoleto. Ha sido sustituido por sistemas multimodales nativos más recientes
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
Datos
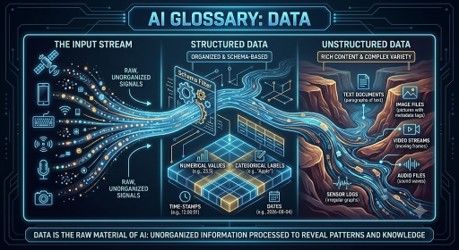
Los datos son la materia prima que utilizan los sistemas de IA. Pueden incluir texto, imágenes, audio, vídeo, números, transacciones, lecturas de sensores o historiales médicos. Los sistemas de IA aprenden patrones a partir de los datos. La calidad, la relevancia y la imparcialidad de los datos son fundamentales. Unos datos deficientes pueden dar lugar a una IA deficiente, por muy avanzado que parezca el modelo.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
Aumento de datos
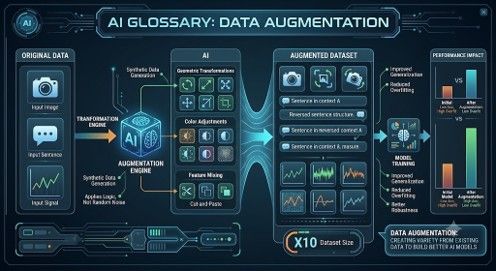
El aumento de datos consiste en crear versiones modificadas de los ejemplos de entrenamiento existentes para mejorar un modelo. En el caso de las imágenes, esto puede incluir rotarlas, recortarlas o modificar su brillo. En el caso del texto, puede implicar parafrasearlo. El objetivo es hacer que el modelo sea más robusto exponiéndolo a variaciones. El aumento de datos resulta especialmente útil cuando el conjunto de datos original es limitado.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
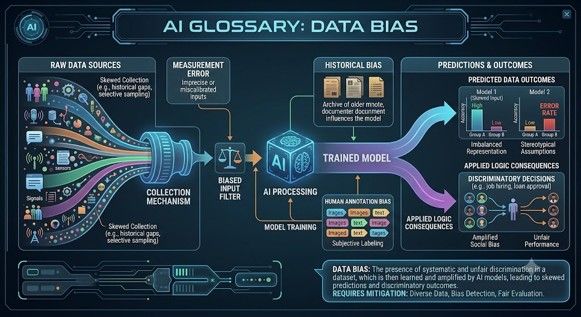
Sesgo de datos
El sesgo de datos se produce cuando los datos utilizados para entrenar o evaluar un sistema de IA no son representativos, están incompletos o son sesgados. Por ejemplo, un sistema de reconocimiento facial entrenado principalmente con un grupo demográfico puede funcionar peor con otros. El sesgo de datos es una de las principales causas de un comportamiento injusto o poco fiable de la IA.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
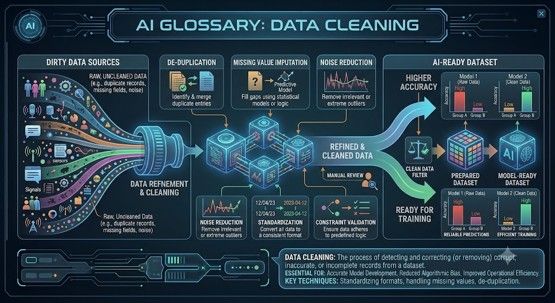
Limpieza de datos
La limpieza de datos es el proceso de corregir, eliminar u organizar datos desordenados antes de su uso. Los datos del mundo real suelen contener duplicados, valores que faltan, errores ortográficos, entradas obsoletas o formatos incoherentes. Los sistemas de IA dependen en gran medida de datos limpios. En muchos proyectos, la limpieza de datos lleva más tiempo que la construcción del modelo.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
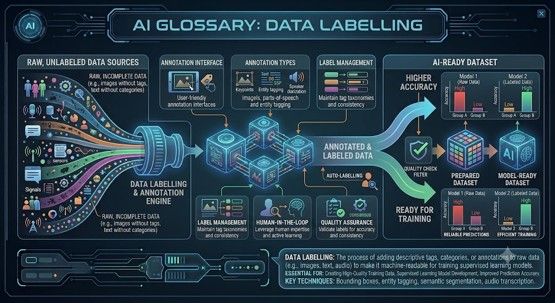
Etiquetado de datos
El etiquetado de datos es el proceso de añadir etiquetas significativas a los datos para que un sistema de IA pueda aprender de ellos. Por ejemplo, etiquetar los correos electrónicos como «spam» o «no spam» ayuda a entrenar un filtro de spam. Etiquetar imágenes médicas puede ayudar a entrenar herramientas de diagnóstico. Un buen etiquetado requiere reglas claras y control de calidad, especialmente cuando se necesita el criterio de un experto.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
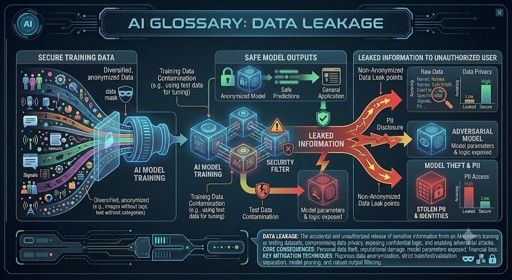
Fuga de datos
La fuga de datos se produce cuando la información de los datos de prueba influye accidentalmente en el proceso de entrenamiento. Esto hace que el modelo parezca mejor de lo que realmente es. Por ejemplo, si un modelo se entrena utilizando información que no estaría disponible en la vida real, la estimación de su rendimiento deja de ser fiable. La fuga de datos es un error común pero grave en los proyectos de aprendizaje automático.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
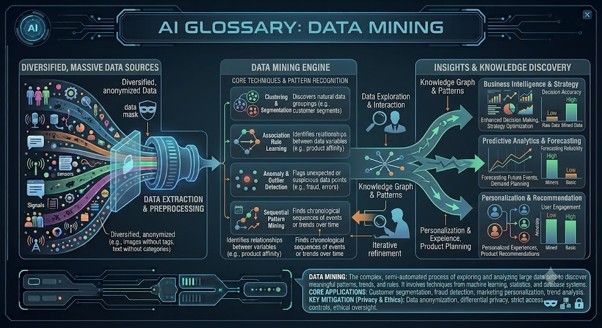
Minería de datos
La minería de datos es el proceso de encontrar patrones, relaciones o información útil en grandes conjuntos de datos. Existía antes de la IA moderna, pero se solapa con el aprendizaje automático. Las empresas utilizan la minería de datos para comprender a los clientes, detectar fraudes, prever la demanda y mejorar las operaciones. El riesgo es que los patrones puedan interpretarse erróneamente o utilizarse sin las garantías de privacidad adecuadas.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
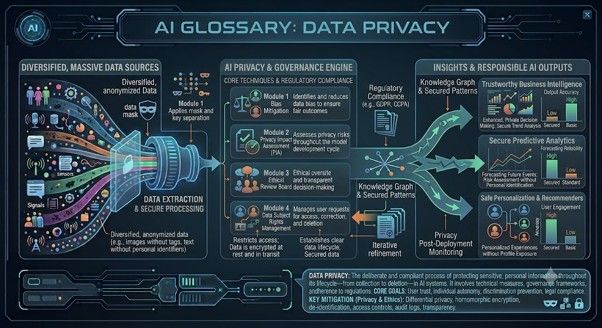
Privacidad de los datos
La privacidad de los datos se refiere a cómo se recopila, utiliza, almacena y comparte la información personal. La IA plantea nuevos retos en materia de privacidad, ya que los modelos pueden entrenarse con grandes conjuntos de datos que incluyen información sensible. Las organizaciones que utilizan la IA deben tener en cuenta el consentimiento, la seguridad, la anonimización, la conservación de datos y el cumplimiento normativo. La privacidad no es solo una cuestión técnica, sino también una cuestión de confianza.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
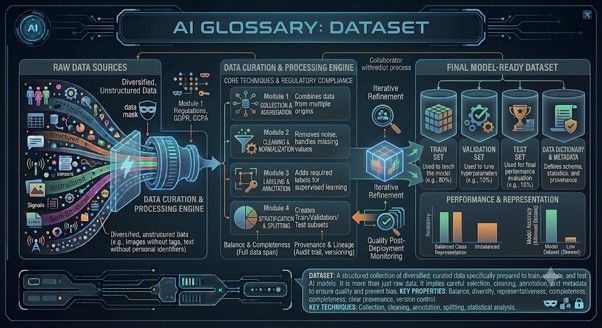
Conjunto de datos
Un conjunto de datos es una recopilación estructurada de datos que se utiliza para entrenar, probar o analizar un sistema de IA. Un conjunto de datos puede contener registros de clientes, imágenes médicas, reseñas de productos, transacciones financieras o fotografías etiquetadas. El tamaño, la calidad y la representatividad del conjunto de datos influyen considerablemente en el rendimiento del modelo.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
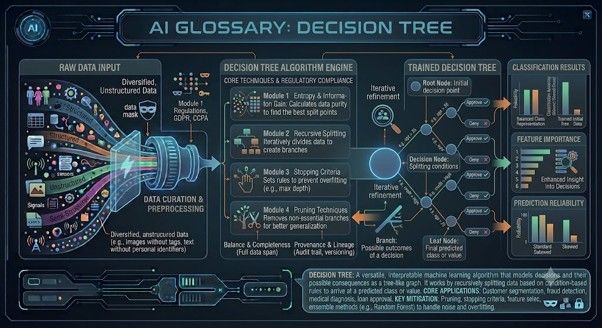
Árbol de decisión
Un árbol de decisión es un modelo de aprendizaje automático que toma decisiones mediante una secuencia de preguntas. Por ejemplo: ¿Es el cliente mayor de 18 años? ¿Ha fallado el pago anteriormente? ¿Es la transacción inusualmente elevada? Los árboles de decisión son populares porque resultan más fáciles de entender que muchos modelos de «caja negra». Se utilizan a menudo en la puntuación de riesgos, la clasificación y las reglas de negocio.
 Créditos: Imagen facilitada; Autor: Stephen Whitelaw;
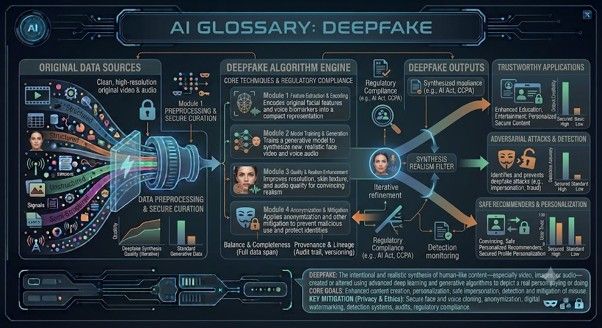
Deepfake
Un deepfake es un contenido multimedia generado o manipulado mediante IA que hace que parezca que alguien dice o hace algo que en realidad no ha dicho ni hecho. Los deepfakes pueden utilizarse con fines de entretenimiento, pero también para cometer fraudes, acosar, difundir desinformación y manipular políticamente. A medida que los deepfakes se vuelven más realistas, la alfabetización mediática y la verificación cobran cada vez más importancia.
Establece The Portugal News como tu fuente preferida de noticias en Google
 Añadir como fuente preferida en Google





 English
 Nederlands
 Deutsch
 Français
 Español
 Italiano
 Svenska
 Pусский
 中文
 Türkçe
 Português
 Czech
 Hungarian
 Polski
 عربي
 Suomi
 עִברִית
 Português (Brasil)

Follow us on social media